Lokalne programowanie AI na GPU 16 GB: Strata, OpenCode i Qwen3.8
Table of Contents
Lokalny agent programistyczny na GPU 16 GB sprawdza się przy ograniczonych zadaniach deweloperskich. Strata i OpenCode łączą lokalne wnioskowanie z edycją plików, poleceniami powłoki i uruchamianiem testów. Zgłoszone uruchomienie Qwen3.8-Flash-Next na RTX 4060 Ti ukończyło aplikację, późniejsze zmiany oraz prototyp gry wyścigowej bez płatnych wywołań wnioskowania.
Zastąpienie subskrypcji wymaga szerszego testu. Opublikowane wyniki pokazują działającą konfigurację na jednym komputerze. Nie dowodzą zgodności z płatnymi usługami programistycznymi dla różnych języków, repozytoriów ani trudnych zadań debugowania. Sprzęt obejmuje także 64 GB pamięci systemowej, która przechowuje dużą część modelu.
Najważniejsze wnioski
- 16 GB oznacza pamięć GPU, a nie całkowitą pamięć potrzebną w zgłoszonej konfiguracji.
- Ponowne użycie promptu ma znaczenie, ponieważ agenci programistyczni wielokrotnie wysyłają nakładającą się historię rozmowy.
- Rozumowanie potrzebuje budżetu, aby planowanie zostawiło miejsce na kod i wywołania narzędzi.
- Przechodzenie wygenerowanych testów jest częściowym dowodem, a Docker i rozgrywka wymagają osobnych kontroli.
- Zerowy koszt API nie obejmuje kosztów posiadania, energii elektrycznej ani czasu utrzymania.
Wymagania wstępne: Kompatybilny komputer, wystarczająca ilość wolnego miejsca na wybrany model, Git, Node.js z npm oraz znajomość narzędzi terminala. Konfiguracja IQ3_S wymaga 64 GB RAM. Użyj aktualnego instalatora Straty, aby sprawdzić inne konfiguracje.
Czas i trudność: Poziom średniozaawansowany. Uwzględnij czas na pobranie dużego modelu i instalację przed oceną szybkości ukończenia zadania. Zgłoszone czasy zadań nie obejmują konfiguracji.
Testowana konfiguracja
| Komponent | Zgłoszona konfiguracja |
|---|---|
| GPU | NVIDIA RTX 4060 Ti, 16 GB VRAM |
| CPU | Intel Core i5-11600K |
| Pamięć systemowa | 64 GB RAM |
| Pamięć masowa | SSD NVMe |
| Model | Qwen3.8-Flash-Next, 125B MoE, IQ3_S |
| Silnik wnioskowania | Strata |
| Agent programistyczny | OpenCode |
| Skonfigurowany kontekst | 65 536 tokenów |
| Skonfigurowany limit wyjścia | 16 384 tokeny |
Opublikowana konfiguracja i wyniki NetworkCodera dostarczają tych wartości. Repozytorium testowe podaje wczytanie 46,84 GiB wag ekspertów w 28 sekund, przy czym 4 431 ekspertów zajęło 8,45 GiB pamięci GPU. Te pomiary opisują testowane uruchomienie. Nie gwarantują takiej alokacji w innej wersji silnika.
Bieżąca zgodność jest szersza niż ten test. Według sprawdzenia z 6 października 2026 r. projekt Strata opisuje wybrane karty NVIDIA i AMD z co najmniej 12 GB VRAM oraz mniejsze modele dla systemów z 32 GB RAM. Te opcje nie odtwarzają eksperymentu z GPU 16 GB, RAM 64 GB i IQ3_S. Przed zakupem sprzętu sprawdź dokładny układ GPU, wariant modelu i obsługę środowiska uruchomieniowego.
Gdzie znajduje się model
Mieszanka ekspertów, czyli MoE, aktywuje podzbiór sieci ekspertów modelu dla każdego tokenu. Ogranicza to aktywne obliczenia w porównaniu z używaniem każdego parametru w każdym kroku. Pozostałe wagi nadal wymagają przechowywania i drogi do obliczeń.
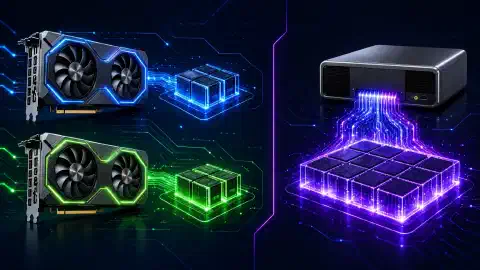
Hybrydowe wykonanie Straty przechowuje często używanych ekspertów na GPU, a całą kolekcję ekspertów zachowuje w RAM systemu. CPU oblicza niebuforowanych ekspertów na miejscu, a GPU obsługuje ekspertów z pamięci podręcznej. Pamięć masowa przechowuje także pliki modelu i dane wyszukiwania. System nie mieści całego modelu 125B w 16 GB VRAM.
Pamięć GPU ma konkurujące zastosowania. Alokacje środowiska uruchomieniowego, stan uwagi i pamięć ekspertów dzielą ograniczony zasób. Więcej miejsca na kontekst zmniejsza pozostałą pojemność pamięci ekspertów. Aktualne wersje Straty obsługują także strumieniowanie pamięci podręcznej KV, więc dokładne rozmieszczenie różni się od starszej konfiguracji. Sprawdź dokumentację techniczną dla swojej wersji silnika.
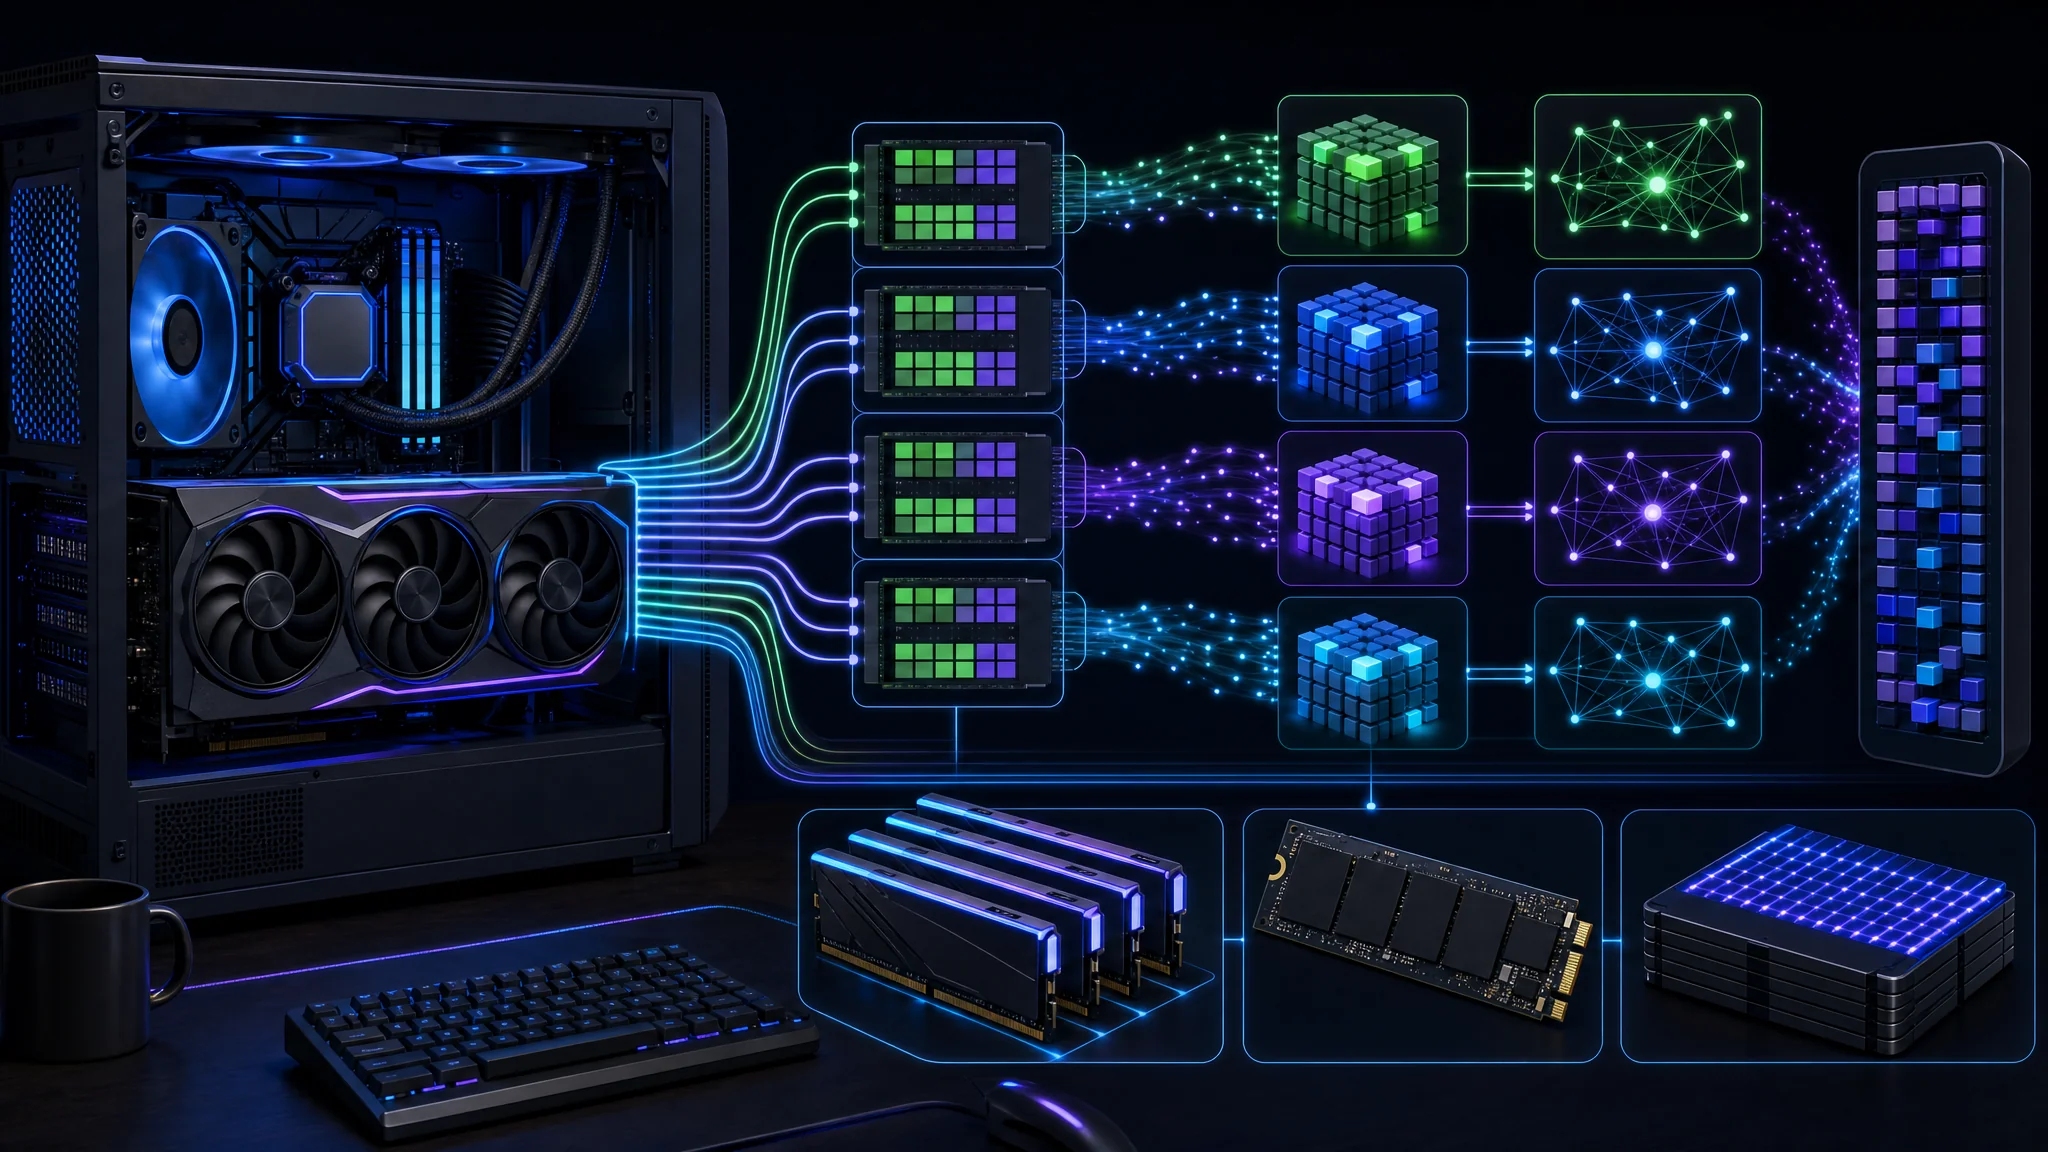
GPU jest jedną częścią systemu wnioskowania obok obliczeń CPU, pamięci RAM systemu i pamięci masowej
Ponowne użycie promptu zmienia szybkość
Agent programistyczny działa w pętli: odczytuje zadanie, żąda działania narzędzia, odbiera wynik i wybiera następne działanie. Zawartość plików, błędy i wyniki testów narastają w rozmowie. Agenci kompresują też kontekst lub wybierają jego fragmenty, więc nie każda implementacja wysyła bez końca całej niezmienionej historii.
Prefill przetwarza tokeny wejściowe przed generowaniem. Decode tworzy odpowiedź. System z szybkim dekodowaniem, lecz wolnym powtarzanym prefill, nadal każe czekać między wywołaniami narzędzi.
Zgłoszony pomiar dla 44 tys. tokenów używał ponownego użycia prefiksu. Strata ponownie wykorzystała wcześniej przetworzoną treść rozmowy, a rosnący prompt był gotowy mniej więcej w ciągu jednej do trzech sekund. To użyteczny dowód dla trwającej sesji agenta. Nie dowodzi przetworzenia 44 000 całkowicie nowych tokenów od zera w ciągu jednej sekundy.
| Pomiar | Co zapisać |
|---|---|
| Zimny prompt | Czas dla nowej treści bez ponownie używalnego stanu prefiksu |
| Ciepła kontynuacja | Czas po dołączeniu wyniku narzędzia do istniejącego kontekstu |
| Szybkość generowania | Tokeny na sekundę podczas odpowiedzi |
| Czas zadania | Planowanie, generowanie, narzędzia, testy i ponowienia razem |
Dwa bufory służą różnym celom. Pamięć ekspertów trzyma często używane wagi blisko obliczeń GPU. Ponowne użycie prefiksu zapobiega powtarzaniu pracy nad wcześniejszym wejściem. Wysoki współczynnik trafień pamięci ekspertów nie dowodzi trafienia pamięci promptu.
Co pokazały zadania
| Zadanie | Zgłoszony czas | Zgłoszony wynik |
|---|---|---|
| Budowa menedżera zadań | 3 min 38 s | API Express, interfejs, testy 5/5 |
| Naprawa edycji i dodanie dat | 4 min 58 s | Zmiany ukończone, testy 6/6 |
| Dodanie eksportu, importu i pakowania | 3 min 48 s | Testy 7/7, kompilacja Dockera niezweryfikowana |
| Gra wyścigowa, pierwsza próba | 6 min 35 s | Wyjście wyczerpane podczas rozumowania, brak kodu |
| Gra wyścigowa, ponowienie z budżetem | 4 min 51 s | Gra wygenerowana, składnia JavaScript sprawdzona |
Opublikowany plik wyników rejestruje szybkości wyjścia 48–52 tokeny na sekundę dla pierwszego zadania, 40–43 dla drugiego i 37–44 dla trzeciego. „Do 52” to maksimum w tych obserwacjach, a nie stała szybkość dla każdego zadania.
Pierwsze trzy zadania rozwijają jedną aplikację. Liczby 5/5, 6/6 i 7/7 opisują kolejne zestawy testów. Ich zsumowanie nie dowodzi 18 niezależnych możliwości. Testy napisane przez tego samego agenta także wymagają przeglądu pod kątem pokrycia i sensownych asercji.
Odzyskiwanie środowiska było częścią pracy. Agent odzyskał działanie po nieodpowiednim poleceniu powłoki i wykrył nieaktualny serwer aplikacji podczas testów. Są to użyteczne zachowania, lecz kończenie istniejącego procesu wymaga świadomych uprawnień we współdzielonym środowisku programistycznym.
Docker pozostał niezweryfikowany. Agent napisał Dockerfile, lecz nie miał działającego silnika Dockera do kompilacji. Przejście testów aplikacji poza kontenerem nie dowodzi działającego obrazu. Ponowienie próby gry sprawdziło składnię i otworzyło przeglądarkę, lecz agent nie miał bezpośredniego potwierdzenia wizualnego rozgrywki.
Zostaw miejsce na wyjście
{
  "reasoning_budget_tokens": 8000
}
Połącz to ustawienie z istniejącą konfiguracją strata-iq3_s.json, zachowując jej pozostałe pola, a następnie uruchom ponownie wybrany model Straty. To ustawienie Straty, a nie zamienny plik konfiguracyjny OpenCode. Sprawdź aktywny budżet w komunikacie startowym.
Strata opisuje twardy budżet rozumowania, który kończy fazę myślenia i przechodzi do odpowiedzi. Wartość na poziomie żądania zastępuje skonfigurowaną wartość domyślną. Ustawienie różni się od ogólnej instrukcji poziomu rozumowania, takiej jak niski lub wysoki.
Pierwsza próba gry zużyła limit 16 384 tokenów podczas planowania. Ponowienie zastosowało budżet myślenia 8 000 tokenów i dostarczyło kod. Wspiera to użycie ograniczonej fazy rozumowania w tym obciążeniu. Nie dowodzi, że 8 000 to najlepsze ustawienie dla każdego zadania.
Pozostały limit wyjścia to maksimum, a nie gwarantowana rezerwa. Gdyby limit 8 000 tokenów został w pełni zużyty przy całkowitym limicie 16 384, przed innymi narzutami pozostałoby około 8 384 tokenów. Dziennik wyników podaje 11 054 zapisanych tokenów w ponowieniu bez pełnego podziału na rozumowanie i kod. Nie interpretuj tego jako 8 000 tokenów rozumowania oraz 11 054 tokenów kodu w ramach tego samego limitu.
Dla wąskich zmian używaj mniejszego budżetu, a następnie testuj większe budżety dla zadań wymagających większej analizy. Sprawdzaj pełny wynik pliku, status zakończenia i wyniki testów. Dłuższe planowanie pomaga tylko wtedy, gdy poprawia dostarczoną zmianę.
Połącz Stratę i OpenCode
git clone https://github.com/Niko1221/Strata.git
cd Strata
./setup.sh
To jest linuksowy punkt wejścia konfiguracji. Sprawdź aktualne instrukcje instalacji i użyj START-HERE.bat dla opisanej ścieżki Windows. Wybierz oryginalny wariant Qwen3.8-Flash-Next IQ3_S oraz kontekst 65 536 tokenów, aby przybliżyć zgłoszoną konfigurację. Zapisz wersję silnika i wybrane pliki modelu w notatkach z testu porównawczego.
npm install -g opencode-ai
Zainstaluj OpenCode według
oficjalnych instrukcji
. W osobnym terminalu zdefiniuj STRATA_BASE_URL jako lokalną bazę API wyświetloną przez Stratę, wraz z przyrostkiem /v1. W tej konfiguracji utrzymuj wnioskowanie związane z komputerem lokalnym.
{
  "provider": {
    "strata": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "Strata local",
      "options": {
        "baseURL": "{env:STRATA_BASE_URL}",
        "apiKey": "local"
      },
      "models": {
        "qwen3.8-flash-next-iq3_s": {
          "name": "Qwen3.8-Flash-Next IQ3_S",
          "limit": { "context": 65536, "output": 16384 }
        }
      }
    }
  },
  "model": "strata/qwen3.8-flash-next-iq3_s"
}
Połącz blok dostawcy z ~/.config/opencode/opencode.json, zachowując istniejące ustawienia. To adaptacja
opublikowanego przykładowego pliku konfiguracyjnego
, która pobiera lokalny punkt końcowy ze zmiennej środowiskowej. OpenCode opisuje
niestandardowych dostawców
oraz
podstawianie zmiennych środowiskowych
.
local jest zastępczym poświadczeniem, zgodnym z przykładową konfiguracją lokalną bez uwierzytelniania. Nie zabezpiecza serwera. Jeśli instancja Straty włącza uwierzytelnianie, przekaż skonfigurowane poświadczenie przez właściwy lokalny mechanizm sekretów.
Uruchom opencode w kopii projektu przeznaczonej do usunięcia i wybierz skonfigurowany model. Sprawdź wybranego dostawcę przed wysłaniem kodu. Deklaracja kontekstu po stronie klienta nie zwiększa kontekstu skonfigurowanego na serwerze, a okno 65 536 tokenów nie zostawia 65 536 tokenów na wejście, gdy potrzebne jest także miejsce na wyjście.
Lokalne wnioskowanie i uprawnienia
{
  "permission": {
    "edit": "ask",
    "bash": "ask"
  }
}
Połącz te początkowe uprawnienia z konfiguracją OpenCode podczas oceny agenta. Dokumentacja uprawnień opisuje dostępne mechanizmy kontroli. Zmiany plików i wykonywanie powłoki wpływają na komputer niezależnie od miejsca wykonywania wnioskowania.
Lokalne wnioskowanie nie sprawia, że każde narzędzie działa lokalnie. Pobieranie pakietów, narzędzia internetowe, integracje zewnętrzne i opcjonalne udostępnianie nadal angażują usługi sieciowe. Przed obsługą prywatnych repozytoriów sprawdź włączone narzędzia. „Model działa lokalnie” to węższe stwierdzenie niż „nic nie opuszcza komputera”.
Rozwiązywanie problemów przy pierwszym uruchomieniu
| Objaw | Co sprawdzić najpierw |
|---|---|
| Dostawca niedostępny | Czy Strata działa i czy zmienna środowiskowa dociera do procesu OpenCode |
| Model nie jest dostępny na liście | Czy identyfikator dostawcy i identyfikator modelu pasują do zapisanej konfiguracji |
| Błąd limitu kontekstu | Czy długość promptu oraz żądane wyjście mieszczą się w aktywnym oknie serwera |
| Planowanie bez kodu | Budżet rozumowania, całkowity limit wyjścia i status zakończenia |
| Wolna kontynuacja | Ponowne użycie prefiksu, presja pamięci, działanie pamięci ekspertów i konkurujące procesy |
| Polecenie Dockera kończy się błędem | Czy dostępny jest działający silnik, a nie tylko klient wiersza poleceń |
Zmieniaj jedno ustawienie naraz i powtarzaj to samo zadanie z zapisanym stanem początkowym. Oddziela to poprawę konfiguracji od innego promptu lub łatwiejszego testu.
Czy zastępuje subskrypcję
| Warto przetestować lokalną konfigurację | Zachowaj inną opcję |
|---|---|
| Istniejący zgodny sprzęt | Zakup sprzętu wyłącznie dla nieprzetestowanego obciążenia |
| Ograniczone zmiany aplikacji | Duże nieznane repozytoria i trudne migracje |
| Powtarzalne testy akceptacyjne | Zadania bez wiarygodnych metod sprawdzania poprawności |
| Czas na utrzymanie środowiska wykonawczego | Praca wymagająca minimalnej konfiguracji i wsparcia |
Zerowy koszt API ma znaczenie, zwłaszcza gdy sprzęt już jest dostępny. Nie obejmuje energii, amortyzacji sprzętu, pamięci masowej ani czasu utrzymania środowiska. Wyświetlane pole zerowego kosztu także nie mierzy tych wydatków.
Porównanie subskrypcji wymaga tych samych zadań. Uruchom ten sam początkowy projekt, instrukcje i kontrole akceptacyjne w obu systemach. Zapisuj ponowienia i poprawki człowieka obok czasu trwania. Uwzględnij nieudaną pierwszą próbę gry podczas oceny całego przepływu, zamiast raportować tylko udane ponowienie.
Użyteczny lokalny agent nie musi być najlepszy we wszystkim. Jeśli niezawodnie obsługuje rutynowe zmiany i pozostawia mały zestaw trudnych zadań innemu narzędziu, już zmienia zakres potrzebnych płatnych usług. Decyzję oprzyj na zaakceptowanej pracy we własnych projektach.
Demonstracja i kolejne kroki
Dalsze oglądanie: Demonstracja lokalnego agenta programistycznego 125B . Powyższe pomiary należą do opublikowanego testu, a nie do niezależnego testu porównawczego wykonanego na potrzeby tego artykułu.
- Odtwórz jedno małe zadanie z ustalonymi kryteriami akceptacji i zapisanym punktem początkowym.
- Zmierz zimne i ciepłe tury, zamiast traktować ponowne użycie prefiksu jako szybkość zimnego prefill.
- Sprawdź pakowanie osobno przez udaną kompilację obrazu, uruchomienie i kontrole na poziomie kontenera.
- Przejrzyj wygenerowane testy i dodaj przypadki, których implementacja nie przewidziała.
- Porównaj ukończoną pracę z obecnym narzędziem programistycznym przed zmianą subskrypcji.
Przy planowaniu sprzętu przeczytaj przewodnik po lokalnych modelach AI i kontekście GPU . Informacje o zachowaniu modeli hostowanych znajdziesz w routingu dostawców OpenRouter i kosztach .
Related Posts