Routing dostawców OpenRouter: jakość modeli, limity tokenów i rzeczywiste koszty
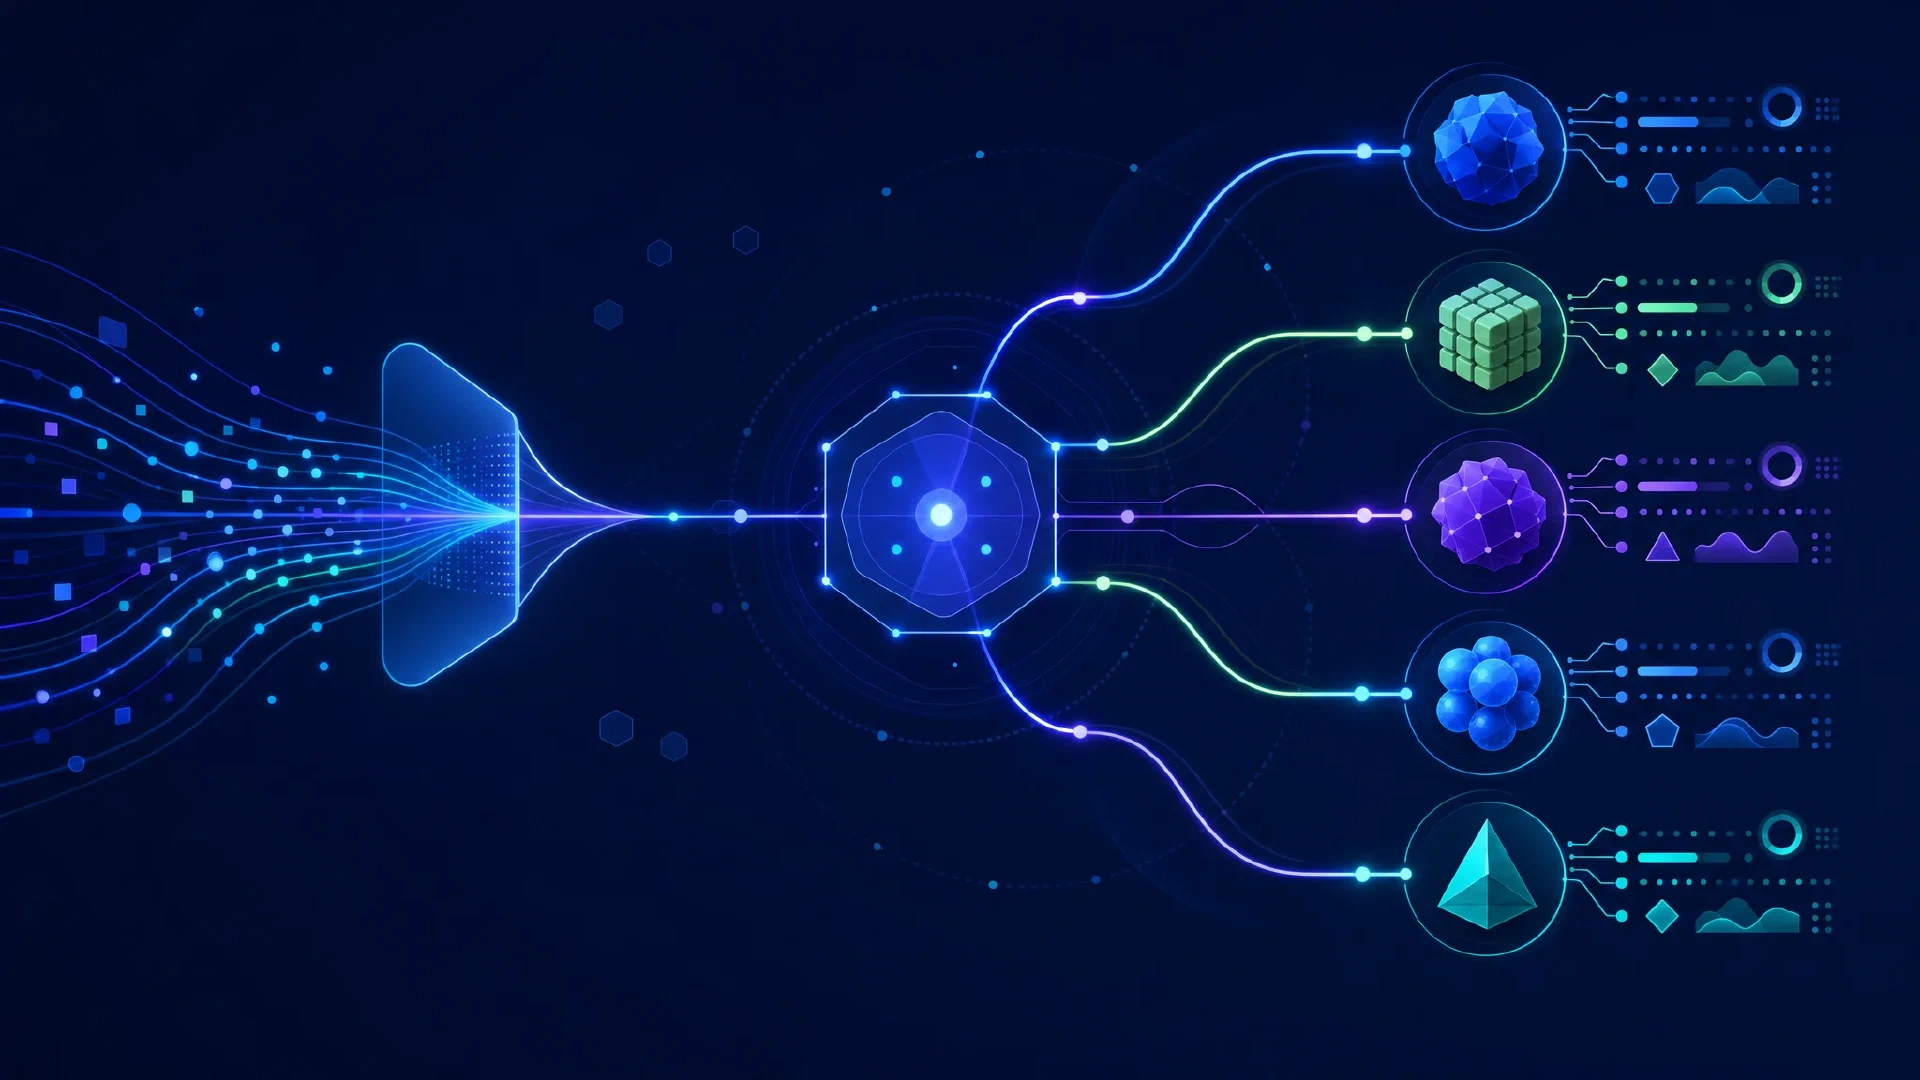
Table of Contents
Routing dostawców OpenRouter wpływa na to, która usługa wnioskowania odpowie na Twoje żądanie. Dwa wywołania z tą samą nazwą modelu nadal zależą od limitów endpointu, obsługiwanych parametrów, oprogramowania serwującego i preferencji routingu. Gdy odpowiedzi stają się krótsze albo wywołania narzędzi zawodzą, najpierw sprawdź te różnice, zamiast obwiniać kwantyzację.
Najważniejsze informacje
- Etykiety precyzji opisują format liczbowy, a nie wynik dokładności.
- Limity endpointu określają dostępny kontekst, długość wyniku i obsługę funkcji.
- Jawny routing wymaga polityki awaryjnej oraz preferencji dostawcy.
- Auto Exacto poprawia wybór dostawcy na podstawie sygnałów jakości, z trasą opt-in dla żądań bez narzędzi.
- Rzeczywisty koszt obejmuje wynik, zachowanie bufora, ponowienia i pomyślne wykonanie zadania.
Wymagania: Znajomość żądań JSON i dostęp do konfiguracji OpenRouter aplikacji. Inspekcja endpointu używa publicznego API. Wysyłanie żądań modelu wymaga klucza API i powoduje naliczenie opłat. Przed powtórzeniem przykładu z określoną datą ponownie sprawdź metadane endpointu.
Czas i trudność: Wstępny przegląd konfiguracji zajmuje około 20 minut. Poziom średniozaawansowany. Przydatne porównanie dostawców wymaga dodatkowych testów z reprezentatywnymi promptami.
Czego nie pokazuje nazwa modelu
Identyfikator modelu wybiera żądany model. Dostawca uruchamia usługę wnioskowania, w tym implementację modelu, limity tokenów i parser wywołań narzędzi. Benchmark na poziomie modelu nie sprawdza każdej usługi hostującej te wagi.
| Właściwość endpointu | Co sprawdzić |
|---|---|
| Długość kontekstu | Miejsce na prompt, historię, wyniki narzędzi i generowanie |
| Maksymalna długość uzupełnienia | Limit wyniku dla żądanego zadania |
| Obsługiwane parametry | Narzędzia, ustrukturyzowany wynik, próbkowanie i sterowanie rozumowaniem |
| Kwantyzacja | Zgłoszony format w porównaniu z pierwotnym wydaniem |
| Ceny | Wejście, wyjście, odczyty bufora i stosowne dodatkowe opłaty |
| Zachowanie usługi | Jakość uzupełnienia, błędy parsowania, opóźnienie i ponowienia |
Routing bazowy preferuje niższe ceny wśród zdrowych kandydatów. OpenRouter opisuje ważenie odwrotnością kwadratu ceny. W uproszczonym przykładzie kandydat za 1 USD otrzymuje dziewięć razy większą wagę wyboru niż kandydat za 3 USD. Opisuje to względne wagi, a nie gwarancję kolejnego żądania. Na wybór wpływają też jawna kolejność, sortowanie, buforowanie i routing jakości. Zobacz dokumentację routingu dostawców .
Ważenie ceną nie określa najniższego rachunku dla Twojego obciążenia. Udokumentowany przykład nie określa uniwersalnej proporcji wejścia do wyjścia dla skalaru ceny. Nie wyprowadzaj prawdopodobieństwa wyboru dostawcy wyłącznie z ceny wejścia.
Odczytuj precyzję w kontekście
Kwantyzacja przechowuje wartości liczbowe w zmniejszonej reprezentacji. Jej wpływ zależy od modelu, metody i implementacji wnioskowania. Niższa precyzja uzasadnia testy, lecz sama etykieta nie pokazuje, że dostawca zmienił pierwotne wagi.
GPT-OSS podaje konkretny przykład. Dokumentacja wydania OpenAI gpt-oss-120b stwierdza, że wagi ekspertów mixture-of-experts używają MXFP4, a oceny używały tej samej kwantyzacji. Etykieta czterech bitów dla tych wag jest zgodna z opublikowanym wydaniem. Nie jest dowodem dodatkowego pogorszenia po stronie dostawcy.
Podnoszenie precyzji konwertuje zapisane wartości do szerszej reprezentacji. Konwersja już skwantyzowanego checkpointu do BF16 nie odzyskuje informacji utraconych podczas kwantyzacji. Z kolei konwersja pierwotnie dokładniejszego checkpointu do czterech bitów wprowadza osobną zmianę wartą oceny.
| Obserwacja | Wspierany wniosek |
|---|---|
| Natywny checkpoint MXFP4 | Czterobitowe wagi ekspertów należą do wydania |
| Etykieta endpointu BF16 | Zgłoszony szerszy format bez dowodu lepszych odpowiedzi |
| Nieznana precyzja | Brak metadanych bez dowodu ukrytej degradacji |
| Zgodne etykiety precyzji | Za mało dowodów na równoważne zachowanie usługi |
Zgodne etykiety nadal nie wykluczają różnic kwantyzacji. Pomijają szczegóły, takie jak skwantyzowane tensory, wybór kalibracji i kernele wykonawcze. Testuj cały endpoint, zamiast traktować głębokość bitową jako ranking jakości.
Sprawdź budżet tokenów
curl --fail --silent --show-error \
  'https://openrouter.ai/api/v1/models/openai/gpt-oss-120b/endpoints' \
  | jq '.data.endpoints[] | {
      name,
      provider_name,
      context_length,
      max_completion_tokens,
      supported_parameters,
      quantization,
      pricing
    }'
API endpointów udostępnia metadane dostawcy dla jednego modelu. To polecenie wymaga curl i jq. Przed wyborem usługi sprawdź
bieżącą odpowiedź endpointu gpt-oss-120b
. Traktuj brakujące lub puste pola jako nieznane, a nie jako nieograniczone. Zapisz lokalny snapshot z datą, gdy porównujesz wyniki.
Sprawdzenie z 5 października 2026 r. zwróciło poniższe reklamowane limity dla gpt-oss-120b. To wartości metadanych, a nie zmierzone długości uzupełnienia. Dostawcy zmieniają je z czasem.
| Dostawca | Tokeny kontekstu | Maksymalna liczba tokenów uzupełnienia |
|---|---|---|
| DigitalOcean | 128,000 | 4,096 |
| Novita | 131,072 | 32,768 |
| Together | 131,072 | 117,964 |
Długość kontekstu i długość wyniku to osobne limity. Model z długim kontekstem nadal potrzebuje miejsca na odpowiedź. Historia rozmowy, instrukcje systemowe i definicje narzędzi zużywają miejsce razem z dokumentem użytkownika.
Tokeny rozumowania także zużywają budżet generowania w obsługiwanych modelach rozumujących. Mały limit grozi niepełnym rozumowaniem, małą ilością widocznego tekstu albo zakończeniem przed odpowiedzią końcową. Sprawdzaj użycie i powód zakończenia, zamiast zakładać, że każda krótka odpowiedź wynika ze słabszych wag. OpenRouter wyjaśnia ten budżet w dokumentacji tokenów rozumowania .
Jawne max_tokens daje routerowi żądaną długość wyniku do porównania z obsługą dostawcy. Wybierz ją na podstawie zmierzonych potrzeb zadania i dostępnego kontekstu. Nadmierna wartość zawęża kwalifikację i nie gwarantuje dłuższej ani lepszej odpowiedzi.
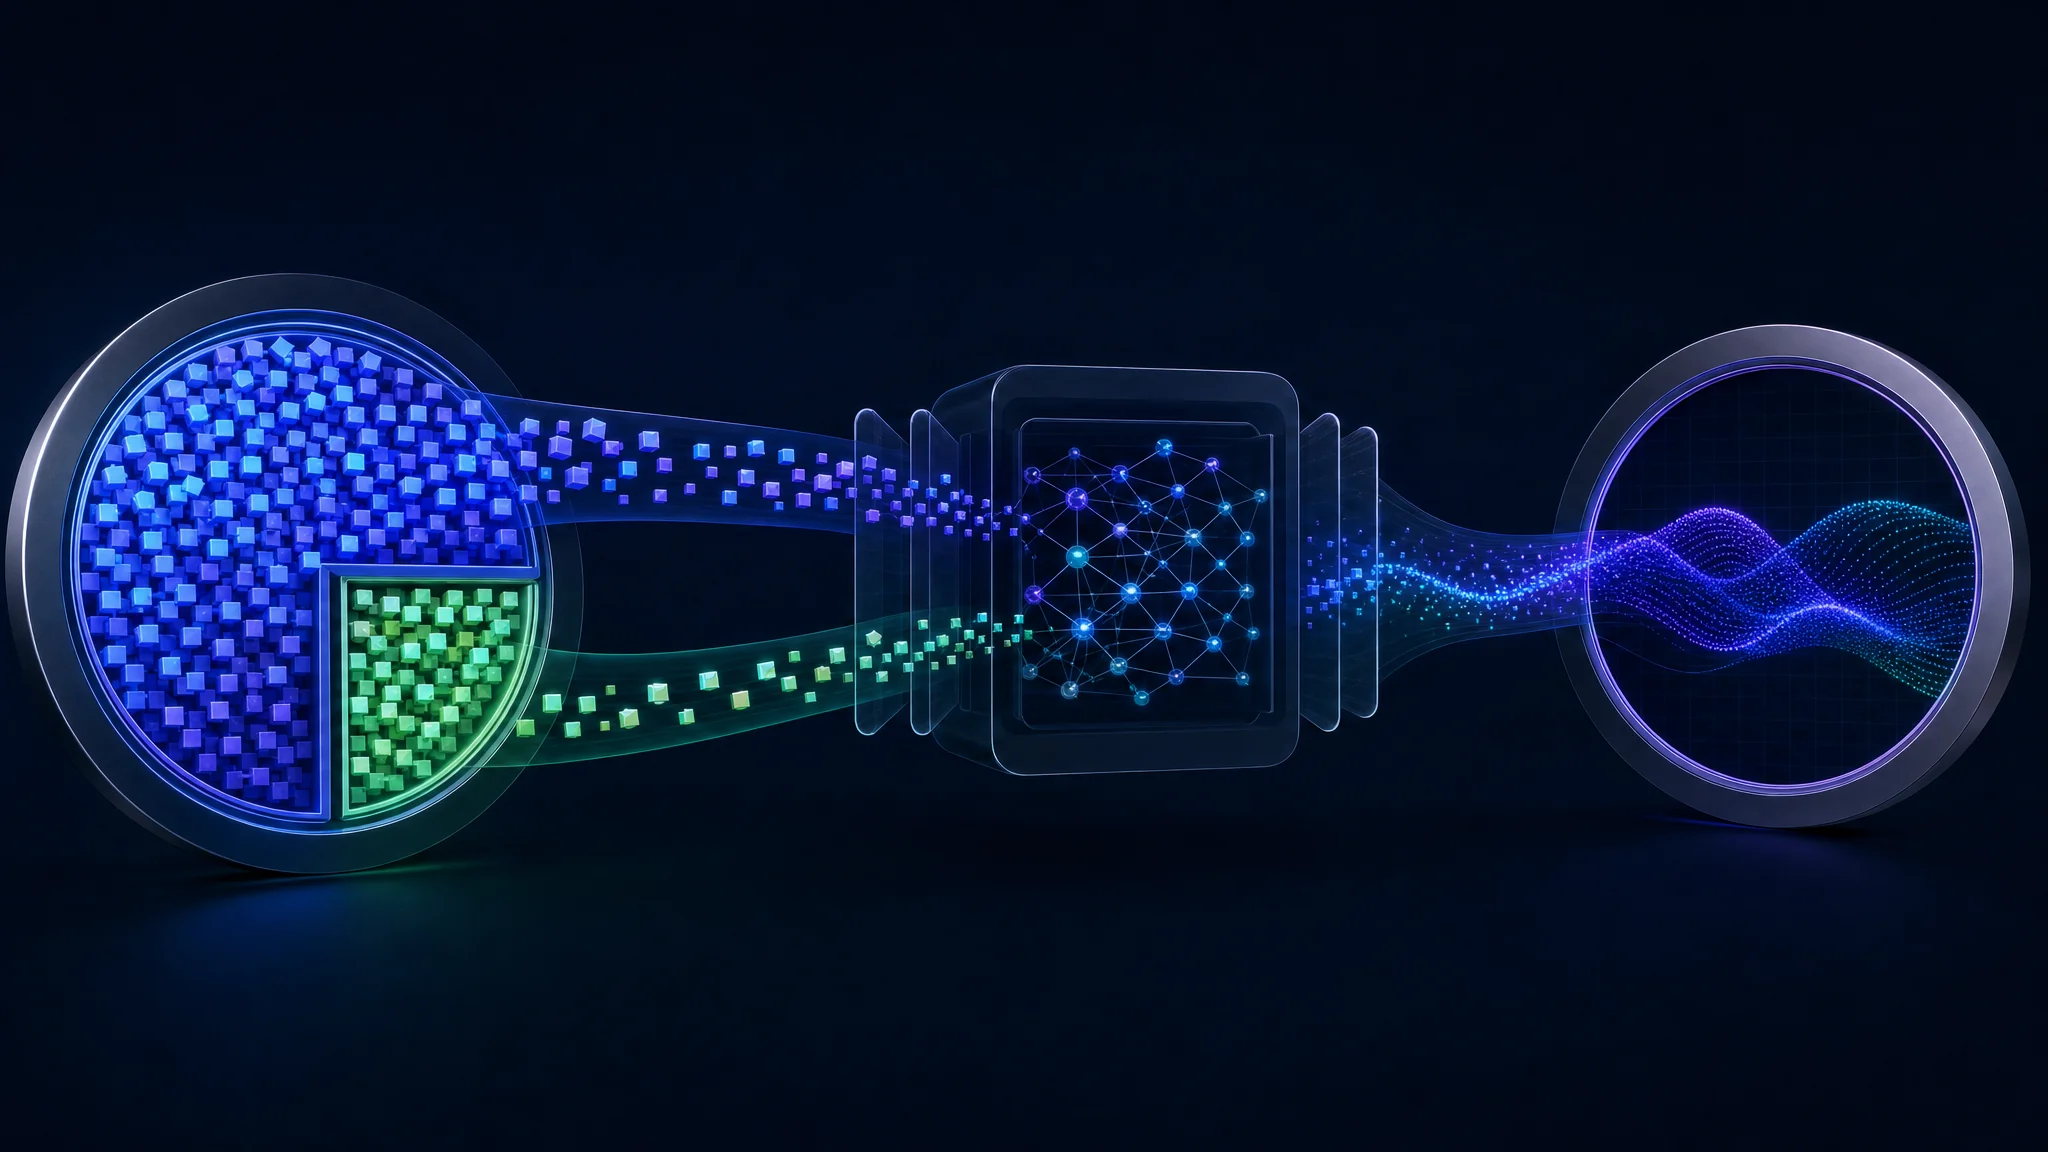
Conceptual token allocation, with reasoning and visible output sharing the completion allowance on supported providers
Wymuś swoje parametry
{
  "model": "openai/gpt-oss-120b",
  "messages": [
    {"role": "user", "content": "Explain the failure modes of a retry loop."}
  ],
  "max_tokens": 8192,
  "provider": {
    "require_parameters": true
  }
}
require_parameters ma domyślnie wartość false. Przy routingu domyślnym nieobsługiwane parametry nie muszą wykluczać endpointu. OpenRouter opisuje dostawców ignorujących nieznane parametry. Ustawienie true filtruje routing według zadeklarowanej obsługi.
Metadane obsługi nie są gwarancją zachowania. Endpoint zgłaszający obsługę seed nadal wymaga testów powtarzalności. Endpoint obsługujący narzędzia nadal wymaga sprawdzania schematu i testów na poziomie aplikacji. Filtr blokuje znane niezgodności przed wejściem do zbioru kandydatów.
Przypinaj dostawców świadomie
{
  "model": "openai/gpt-oss-120b",
  "messages": [
    {"role": "user", "content": "Summarize the supplied incident report."}
  ],
  "max_tokens": 8192,
  "provider": {
    "order": ["REPLACE_WITH_VERIFIED_PROVIDER_SLUG"],
    "allow_fallbacks": false,
    "require_parameters": true
  }
}
Zastąp placeholder slugiem dostawcy skopiowanym z listy dostawców modelu. Dołącz raport w rzeczywistym żądaniu. Ten szablon służy do przeglądu konfiguracji. Nie jest wykonywalnym żądaniem, dopóki nie zastąpisz placeholdera.
order ustala preferencję. Samo pole pozostawia włączony fallback do innych dostawców. Połączenie z allow_fallbacks: false ogranicza routing do wymienionych dostawców. Oczekuj nieudanego żądania, gdy żaden nie spełnia wymagań albo nie jest dostępny.
Warianty endpointu wymagają uwagi. Bazowy slug dostawcy pasuje do wielu wariantów według udokumentowanych reguł dopasowania. Użyj konkretnego sluga wariantu podczas testowania określonej konfiguracji usługi. Dla każdej odpowiedzi ponownie sprawdź zgłoszonego dostawcę.
quantizations jest allowlistą nazwanych formatów, a nie minimalną wartością liczbową. Tablica zawierająca "fp8" wybiera pasujące endpointy FP8. Nie obejmuje automatycznie BF16 ani wszystkich formatów z większą liczbą bitów. Najpierw porównaj pierwotny checkpoint, a potem stosuj filtr tylko wtedy, gdy ocena uzasadnia ograniczenie.
Zachowaj włączony routing jakości
{
  "model": "openai/gpt-oss-120b:exacto",
  "messages": [
    {"role": "user", "content": "Compare the two supplied incident reports."}
  ],
  "max_tokens": 8192,
  "provider": {
    "require_parameters": true
  }
}
Auto Exacto używa przepustowości, telemetrii wywołań narzędzi i benchmarków, aby obniżyć priorytet słabszych dostawców. Ogłoszenie OpenRouter z marca 2026 podaje spadek błędów wywołań narzędzi GLM-5 o 88%, z około 8% do około 1%. Podaje też zmianę gpt-oss-120b z 5,6% do 3,5%.
To wyniki zgłoszone przez dostawcę, a nie obietnica dla Twojej aplikacji. Ważność wywołania narzędzia mierzy JSON, nazwy i schematy. Poprawne składniowo wywołanie nadal wymaga właściwych argumentów i działania dla zadania użytkownika.
Żądania zawierające narzędzia domyślnie otrzymują Auto Exacto, gdy model ma wystarczające pokrycie dostawców. Dla innych żądań :exacto włącza routing jakości. Obecna dokumentacja wspiera więc routing jakości dla podsumowań i czatu oraz dla narzędzi.
sort: "price", przyrostek :floor i domyślne sortowanie cen na poziomie konta wyłączają Auto Exacto. Sprawdź razem ustawienia aplikacji i preferencje konta. Przed połączeniem kontroli routingu zajrzyj do
dokumentacji Auto Exacto
.
Oblicz koszt obciążenia
Sama cena wejścia nie wystarcza do porównania. Rozważ poniższe przykładowe stawki w dolarach za milion tokenów. Pokazują arytmetykę i nie są bieżącymi ofertami dostawców.
| Przykładowy endpoint | Cena wejścia | Cena wyjścia |
|---|---|---|
| A | $0.03 | $16.00 |
| B | $0.42 | $1.32 |
Workload: 6 million input tokens + 1 million output tokens

A = 6 × $0.03 + 1 × $16.00 = $16.18
B = 6 × $0.42 + 1 × $1.32  =  $3.84

Per million combined input and output tokens:
A = $16.18 / 7 = $2.31
B =  $3.84 / 7 = $0.55
Endpoint A kosztuje około 4,2 raza więcej dla tej proporcji pomimo niższej ceny wejścia. Stosunek ceny wyjścia do wejścia 533 do 1 w A łączy dwie stawki, a nie mnożnik całkowitego kosztu użytkownika. Inne proporcje wejścia i wyjścia zmieniają porównanie.
Jednostki cen API różnią się od tabel porównawczych. API endpointu podaje ceny tokenów za token. Pomnóż je przez milion przed porównaniem z powyższymi stawkami.
Buforowanie promptu wprowadza kolejną zmienną. Odczyty z bufora, zapisy bufora i wejście bez bufora wymagają osobnego rozliczenia według zasad dostawcy. Powtarzający się tekst nie gwarantuje trafienia w bufor. Sprawdzaj zgłoszone liczby buforowanych tokenów i koszty w dokumentacji buforowania promptów .
Routing wpływa na ciągłość bufora. OpenRouter opisuje przyklejony routing dla buforowania, a ręczna kolejność dostawców ma pierwszeństwo. Auto Exacto także zmienia kolejność dostawców i czasem przerywa ciepły bufor. Przed zmianą polityki porównaj obserwowane oszczędności bufora z jakością i kosztami ponowień.
Koszt zaakceptowanego wyniku jest użyteczną metryką aplikacji. Podziel całkowity wydatek, w tym ponowienia i nieudane próby, przez wyniki spełniające kryteria akceptacji. Osobno uwzględnij stosowne opłaty pozatokenowe. Niska stawka tokenowa nie kompensuje powtarzających się nieudanych zadań.
Diagnozuj niespójną odpowiedź
| Objaw | Pierwsza kontrola |
|---|---|
| Krótka lub nieukończona odpowiedź | Powód zakończenia, limit wyniku, użycie rozumowania |
| Brak szczegółów dokumentu | Przesłana treść, limit kontekstu endpointu, obcięcie po stronie klienta |
| Błędne wywołanie narzędzia | Zgłoszona obsługa, schemat narzędzia, zachowanie parsowania |
| Inne zachowanie próbkowania | Żądane parametry i zadeklarowana obsługa |
| Nieoczekiwany wydatek | Ilość wyniku, odczyty bufora, ponowienia, zmiany dostawcy |
| Brak kwalifikującego się dostawcy | Sprzeczne limity, allowlisty i ograniczenia fallbacku |
Zachowaj identyfikator generowania zwrócony z odpowiedzią. API metadanych generowania OpenRouter udostępnia tożsamość dostawcy, użycie, koszt i informacje o zakończeniu. Identyfikator sesji grupuje powiązaną pracę, lecz nie zastępuje identyfikatora generowania przy wyszukiwaniu pojedynczego żądania.
Zapisz żądanie razem z identyfikatorem generowania. Zachowaj model, preferencje dostawcy, żądane parametry, znacznik czasu i użycie odpowiedzi. Późniejsze porównanie jakości lub kosztu pozostanie odtwarzalne, gdy routing, ceny albo metadane endpointu się zmienią.
Porównuj endpointy w tych samych warunkach. Użyj tego samego promptu, narzędzi, ustawień rozumowania i budżetu tokenów. Powtórz test dla kilku reprezentatywnych zadań. Oddziel niepełne odpowiedzi, nieprawidłowe wywołania narzędzi i błędne odpowiedzi, zamiast łączyć je w jeden niewyjaśniony wynik jakości.
Niepewność benchmarku ma znaczenie. Analiza Epoch AI dlaczego benchmarking jest trudny opisuje zmienność wynikającą z implementacji, próbkowania i rusztowań agentów. Jedna rozczarowująca odpowiedź nie dowodzi trwałej wady dostawcy ani jej przyczyny.
Przewodnik po routingu endpointu
Dalsze oglądanie: Dyskusja o jakości i routingu endpointów OpenRouter . Przed użyciem konkretnych cen, limitów lub porównań dostawców ponownie sprawdź listy endpointów.
Następne kroki
- Sprawdź endpointy jednego modelu i zapisz limity ważne dla Twojego obciążenia.
- Wybierz politykę routingu z jawnymi wymaganiami parametrów i zachowaniem fallbacku.
- Przetestuj reprezentatywne zadania na kandydujących endpointach i routingu jakości.
- Zapisuj koszt zaakceptowanego wyniku razem z opóźnieniem, użyciem bufora i kategoriami awarii.
- Sprawdzaj ponownie po zmianach wersji modelu, zachowania usługi albo cen dostawcy.
Podstawy AI znajdziesz w artykule Podstawowe pojęcia AI . O uprawnieniach agentów i kontrolach walidacji przeczytaj w artykule Zabezpieczanie systemów AI .
Related Posts