Czy 16 GB VRAM wystarczy do poważnej pracy z lokalnym LLM?
Table of Contents
16 GB dedykowanej pamięci GPU wystarcza do poważnej pracy z lokalnym LLM, gdy model, kontekst i runtime mieszczą się razem. Załadowanie wag spełnia tylko pierwszy warunek. Zestaw potrzebuje też pamięci na bieżącą rozmowę i odpowiedniej szybkości, aby ukończyć zadanie.
Użyj Qwen3.8 27B jako przykładu budżetowania jednoosobowego przepływu pracy z kodem lub dokumentami. Najpierw określ kontekst wymagany przez zadanie, potem wybierz wagi i ustawienia runtime mieszczące się w pozostałej pamięci. Specyfikacje sprzętu i źródła modelu sprawdzono 7 października 2026 r.
Najważniejsze wnioski
- Zarezerwuj pamięć na kontekst przed wyborem kwantyzacji.
- Mierz przetwarzanie promptu osobno od szybkości wyjścia.
- Wyłącz nieużywaną obsługę wizji i przetestuj 8-bitową pamięć podręczną KV.
- Porównuj dokładną kartę GPU, backend, plik modelu i długość promptu.
- Oblicz oszczędność posiadania na podstawie swojego obciążenia i rachunku dostawcy.
Do ćwiczenia potrzebujesz logu pamięci runtime, dokładnej nazwy pliku modelu i reprezentatywnego zadania. Przeznacz około 20 minut na konfigurację i zapis wyników, poza czasem inferencji. Poziom trudności jest średni.
Dopasuj pamięć do pracy
16 GB pasuje do obciążenia, którego wagi, aktywny kontekst i alokacje tymczasowe mieszczą się w dostępnej pamięci GPU. Wymagany kontekst zależy od zadania. Krótkie streszczenie dokumentu i agent programistyczny czytający dziesiątki plików potrzebują innych budżetów.
| Obciążenie | Pierwsze pytanie przy doborze |
|---|---|
| Krótki czat lub redakcja | Czy model spełnia wymagania jakościowe? |
| Analiza dokumentów | Czy tekst źródłowy i odpowiedź mieszczą się razem? |
| Agent programistyczny | Ile kontekstu zajmują pliki i wyniki narzędzi? |
| Równoczesne żądania | Ile cache potrzebuje każda aktywna sesja? |
Skonfigurowane okno różni się od zajętego okna. Benchmark z limitem 64K i krótkim promptem nie mierzy generowania po 55K tokenów rozmowy. Przed wyborem sprzętu testuj w pobliżu oczekiwanej długości sesji.
Dlaczego model się mieści
Kwantyzacja zapisuje wagi z użyciem mniejszej liczby bitów. Tabela plików Qwen3.8 27B firmy Bartowski podaje dla Q4_K_M 17,44 GB, czyli już więcej niż około 17,18 miliarda bajtów urządzenia 16 GiB przed doliczeniem pamięci runtime.
Karta modelu GSQ-RCO ISTA-DASLab podaje dla IQ3_S 11,8 GB. Metoda przydziela różną precyzję różnym tensorom w ramach budżetu rozmiaru. Opcjonalna wersja MTP dodaje około 0,35 GB, a projektor wizji około 0,9 GB.
| Opublikowany benchmark | Wynik BF16 / IQ3_S |
|---|---|
| AIME25 | 100.00 / 100.00 |
| LiveCodeBench v6 | 85.71 / 85.71 |
| GPQA-Diamond | 89.90 / 89.39 |
Laboratorium nazywa ten punkt pracy „task-lossless”. Wyniki wspierają wąskie porównanie. Nie dowodzą identycznych odpowiedzi, równego wyszukiwania w długim kontekście ani równej niezawodności w twoich zadaniach programistycznych. Sprawdź skompresowany model według własnych kryteriów akceptacji.
Policz cache
Cache KV przechowuje klucze i wartości uwagi dla wcześniej przetworzonych tokenów. Prompt, wyniki narzędzi i wygenerowane odpowiedzi zużywają kontekst. Niektóre runtime przydzielają pojemność cache przy starcie, więc wyświetlana pamięć nie musi rosnąć z każdą wiadomością.
Konfiguracja Qwen określa 64 warstwy, pełną uwagę w co czwartej warstwie, cztery głowice KV i wymiar głowicy 256. Dla tych 16 warstw pełnej uwagi obliczony koszt cache FP16 wynosi:
16 layers × 4 KV heads × 256 elements × 2 (K and V) × 2 bytes
= 65,536 bytes per token
= 64 KiB per token
Obliczenie pomija stan rekurencyjny, wyrównanie, bufory tymczasowe i alokacje dekodowania spekulatywnego. Inne architektury wymagają innych obliczeń.
| Zajęte tokeny | Cache pełnej uwagi FP16 |
|---|---|
| 32,768 | 2 GiB |
| 65,536 | 4 GiB |
| 131,072 | 8 GiB |
| 262,144 | 16 GiB |
KiB i GiB używają tu potęg 1024. Rozmiary pobieranych modeli używają dziesiętnych GB. Mieszanie jednostek zniekształca pozostały budżet.
Zaplanuj dostępny kontekst
Dwa ustawienia uwalniają pamięć dla dłuższych sesji tekstowych: usuń nieużywany projektor wizji i zmniejsz precyzję cache. Oblicz ich wpływ względem załadowanego modelu i alokacji runtime.
W tym przykładzie wszystkie alokacje podano w dziesiętnych GB. Rezerwa 1,0 GB to założenie planistyczne, a nie uniwersalna wartość domyślna runtime.
| Alokacja | Wizja włączona / wyłączona |
|---|---|
| Fizyczna pojemność 16 GiB | 17.180 / 17.180 GB |
| Wagi modelu | 11.800 / 11.800 GB |
| Opcjonalna głowica MTP | 0.350 / 0.350 GB |
| Szacunek projektora wizji | 0.930 / 0 GB |
| Założone pozostałe alokacje | 1.000 / 1.000 GB |
| Miejsce na rosnący cache | 3.100 / 4.030 GB |
Przy 65 536 bajtach na token 3,100 GB mieści około 47 300 tokenów. Przy idealnym zapisie 8-bitowym byłoby 32 768 bajtów na token i około 123 000 tokenów po wyłączeniu wizji.
Rzeczywisty zapis q8_0 zawiera skale bloków. Przy 34 bajtach na 32 wartości ten przykład potrzebuje około 34 816 bajtów na token, co zmniejsza szacunek do około 115 700. Dodatkowe alokacje obniżą wynik. Około 110K to więc rozsądny wynik planowania przy tych założeniach, a nie gwarantowane ustawienie.
Pozostały kontekst musi obejmować wejście i wyjście. Przy oknie 65 536 tokenów przykładowy początkowy prompt 30 000 tokenów i limit wyjścia 8 192 tokenów zostawiają 27 344 tokeny na pliki, wyniki narzędzi i rozmowę. Budżet promptu jest przykładem. Zmierz własne narzędzia i instrukcje.
Ustawienia warte testu
Dokumentacja serwera llama.cpp opisuje osobne typy cache klucza i wartości, automatyczne ładowanie projektora oraz równoległe sloty. Dla obciążenia tekstowego testuj wyłączoną wizję, q8_0 dla obu typów cache i jeden slot. Najpierw użyj umiarkowanego kontekstu.
Zapisz alokacje przed zwiększeniem kontekstu. Kwantyzacja cache wymaga obsługi wybranej architektury i backendu. Po zmianie precyzji sprawdź jakość odpowiedzi. Zachowaj działającą konfigurację do porównań.
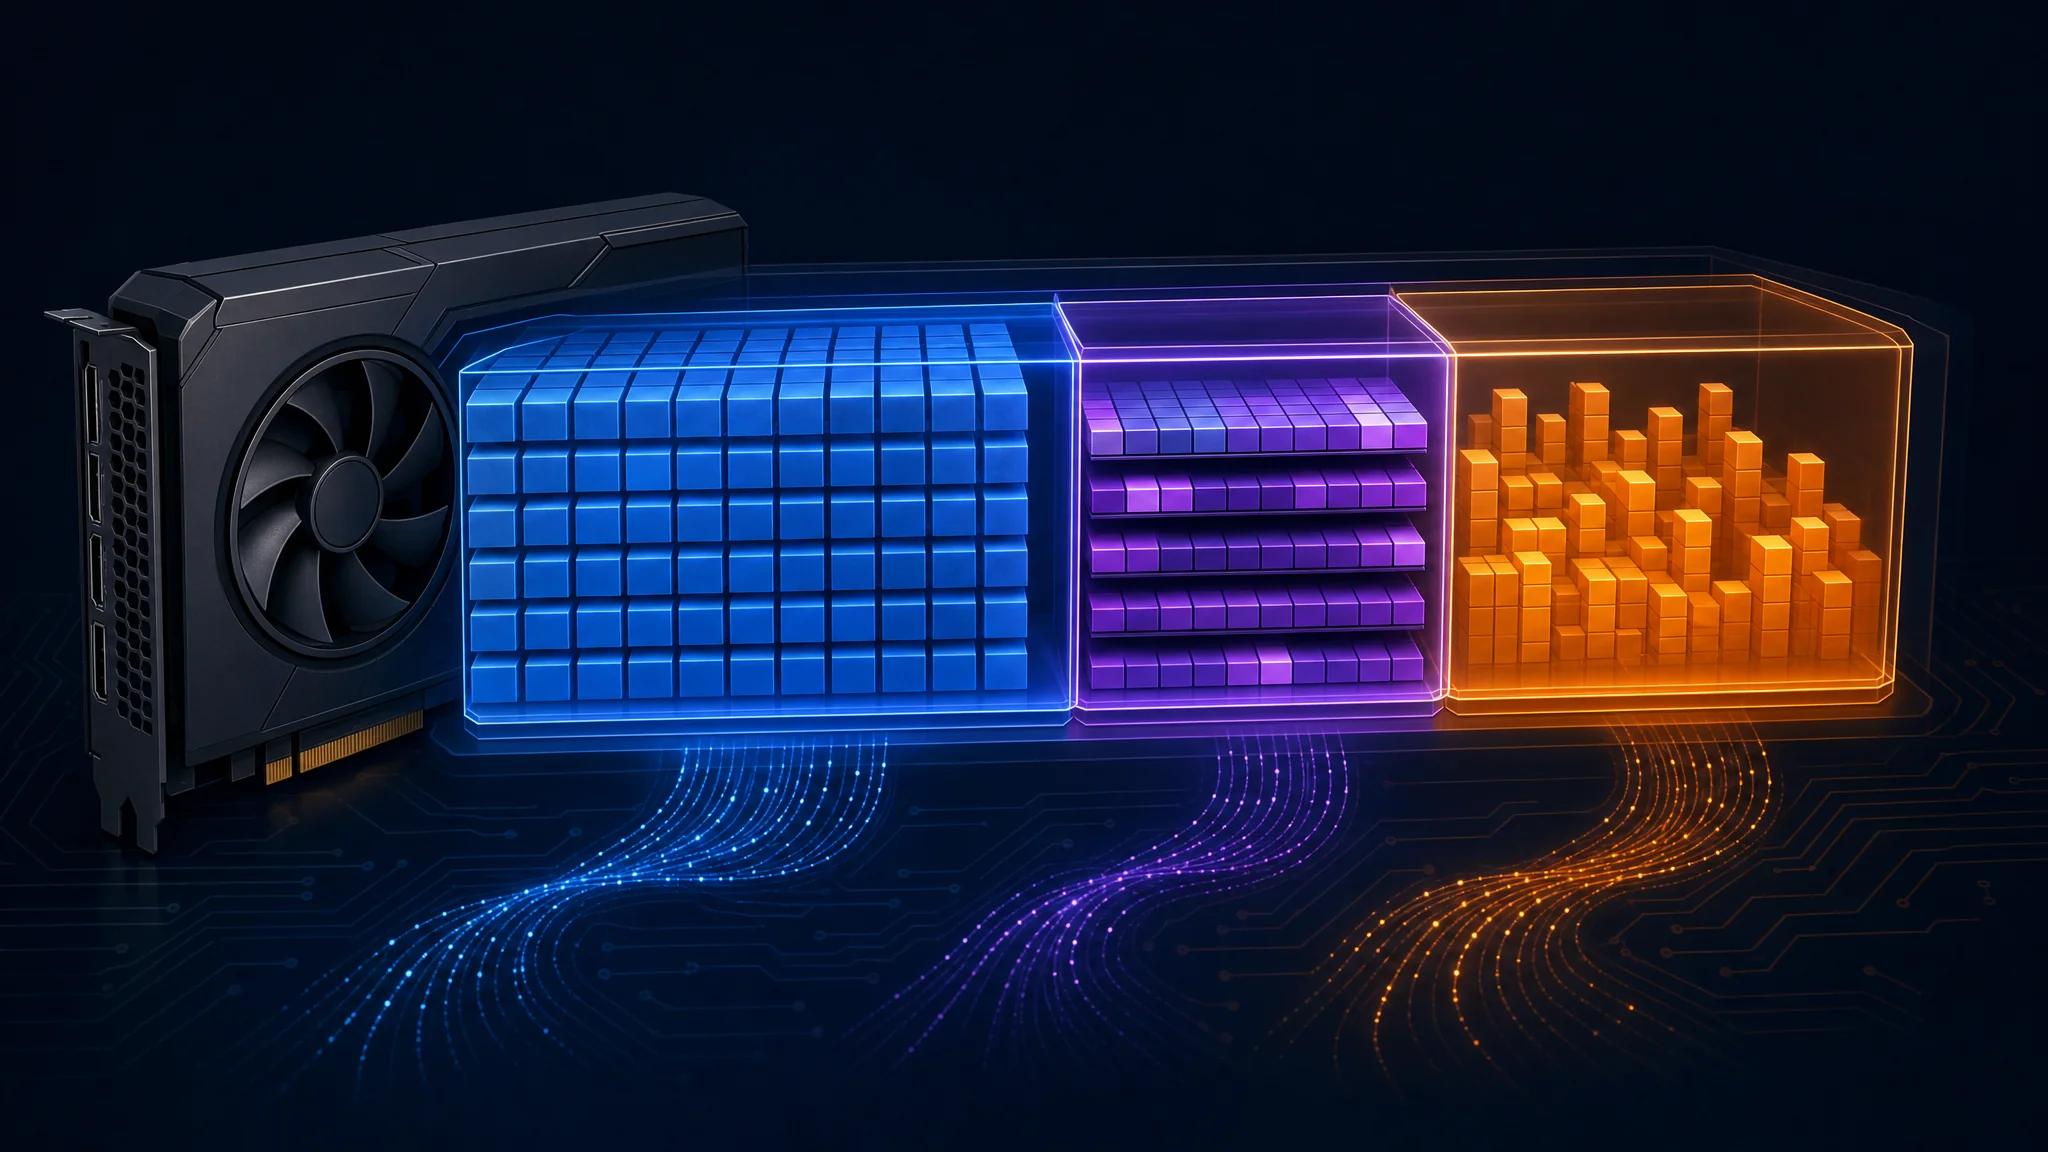
Niebieski oznacza wagi, fioletowy cache kontekstu, a pomarańczowy alokacje runtime. Rozmiary są poglądowe
Dlaczego prędkości się różnią
Oznaczenie 16 GB opisuje pojemność. Przepustowość zależy też od przepustowości pamięci, kerneli obliczeniowych, aktywnego kontekstu, offloadu, batchingu i dekodowania spekulatywnego.
| Przyczyna | Co sprawdzić |
|---|---|
| Offload do CPU lub RAM | Rozmieszczenie załadowanych warstw i lokalizacja cache |
| Długi kontekst | Zajęte tokeny podczas pomiaru |
| Różnice backendu | Commit runtime, sterownik i ścieżka kernela |
| Dekodowanie spekulatywne | Zaakceptowane szkice i dodatkowe alokacje |
Dla gęstego modelu generującego jeden token naraz przepustowość pamięci podzielona przez liczbę bajtów rezydentnych wag daje przybliżenie oparte wyłącznie na przepustowości. Przy 448 GB/s i 11,8 GB wag iloraz wynosi około 38 tokenów na sekundę. Odczyty cache i obliczenia dodają pracę, a dekodowanie spekulatywne i batching zmieniają założenia.
Nie traktuj tego ilorazu jako uniwersalnej górnej granicy. Wyższa zgłoszona szybkość wyjścia nie unieważnia automatycznie benchmarku. Sprawdź, czy jeden przebieg modelu docelowego zaakceptował kilka tokenów szkicu.
Predykcja wielu tokenów, czyli MTP, wymaga zgodnego modelu i runtime. Porównuj przebiegi włączone i wyłączone przy krótkim i długim zajętym kontekście. Dodatkowe wagi i stan szkicu zużywają pamięć, lecz nie istnieje uniwersalna zasada nakazująca wyłączenie MTP po 32K tokenów.
Zmierz pierwszą odpowiedź
Prefill przetwarza prompt przed generowaniem. Decode tworzy odpowiedź. Szybki decode ukrywa powolną pierwszą odpowiedź, gdy zadanie zaczyna się od dużego promptu bez cache.
Podziel niebuforowane tokeny promptu przez zmierzoną przepustowość prefill, aby oszacować czas przetwarzania. Dla świeżego promptu 30 000 tokenów dwie przykładowe wartości dają następujące oczekiwanie:
| Przykładowa szybkość promptu | Obliczony czas przetwarzania |
|---|---|
| 750 tokenów/s | 40 sekund |
| 150 tokenów/s | 200 sekund |
Przykłady opisują czas przetwarzania bez ładowania modelu i narzutu żądania. Na zmierzoną szybkość wpływają długość promptu, rozmiar batcha, format modelu i backend.
Zmierz osobno zimne żądanie i kontynuację z ponownie używanym prefiksem. Ponowne użycie prefiksu pomija część powtarzanego wejścia. Zapisz czas do pierwszego tokena, szybkość decode i całkowity czas zadania.
Porównaj kompletne zestawy GPU
Porównuj razem cenę zakupu, użyteczną pamięć, przepustowość i ścieżkę programową. Tańsza karta traci przewagę, jeśli obciążenie wymaga nieobsługiwanych funkcji albo przekracza cel opóźnienia.
| Desktopowa karta 16 GB | Przepustowość pamięci |
|---|---|
| RX 9060 XT | 320 GB/s |
| RTX 5060 Ti | 448 GB/s |
| RX 9070 | 640 GB/s |
| RX 9070 XT | 640 GB/s |
Specyfikacje AMD RX 9070 i RX 9070 XT potwierdzają 16 GB i przepustowość do 640 GB/s. Porównanie 640 do 448 daje około 43% większą teoretyczną przepustowość. Z tych specyfikacji nie wynika 43% poprawy inferencji.
Wybieraj benchmarki z planowanym modelem i backendem. Dla krótkich promptów i ciągłego generowania większą wagę ma decode. Przy analizie repozytoriów priorytetem są zimny prefill, szybkość długiego kontekstu i pomyślne ukończenie zadania. Przed zakupem sprawdź dostępne oprogramowanie obu dostawców.
Maki i oznaczenia laptopów
Mac z układem Apple silicon i 16 GB dzieli pamięć między CPU, GPU, system operacyjny i aplikacje. Dedykowana karta 16 GB ma pamięć wideo obok RAM systemu. Te pojemności nie opisują równoważnych budżetów modelu.
Apple udostępnia zalecany rozmiar zestawu roboczego GPU . Sprawdź limit zgłoszony przez runtime i presję pamięci systemu. Zostaw miejsce na macOS i inne aplikacje zamiast przeznaczać całą wspólną pulę na inferencję.
W laptopach sprawdź dokładny SKU, pamięć dedykowaną, limit mocy GPU i chłodzenie. Strona rodziny RTX 5060 firmy NVIDIA wymienia warianty pamięci desktopowej RTX 5060 Ti. Sama nazwa rodziny nie potwierdza 16 GB, a wyniki desktopa nie potwierdzają przepustowości laptopa.
Czy posiadanie się opłaca?
Zakup opłaca się finansowo, gdy uniknięte opłaty za hosting przewyższają koszty działania i zwracają cenę sprzętu. Zacznij od przykładu obejmującego tylko wyjście: karta za 789 USD, 35 tokenów wyjściowych/s, 180 W podczas generowania, prąd po 0,18 USD/kWh i 2,95 USD za milion hostowanych tokenów wyjściowych. To dane ilustracyjne. Zastąp je własną ceną, zmierzoną mocą, stawką prądu i ceną dostawcy.
Hours per million output tokens = 1,000,000 ÷ 35 ÷ 3,600 = 7.94
Electricity per million = 7.94 × 0.180 kW × $0.18/kWh = $0.257
Savings per million = $2.95 - $0.257 = $2.693
Break-even output = $789 ÷ $2.693 = 293 million tokens
Continuous generation time = 293 × 7.94 ÷ 24 = about 97 days
Przy ośmiu godzinach nieprzerwanego generowania dziennie to samo obliczenie trwa około 291 dni. Osiem godzin z otwartym asystentem różni się od ośmiu godzin generowania tokenów.
Przy cenie hostowanego wyjścia 0,16 USD za milion lokalny prąd w tym scenariuszu kosztuje już więcej niż hosting. Przy tych założeniach nie ma dodatniego progu zwrotu dla samego wyjścia.
Użyj aktualnych cen modeli OpenRouter wybranego dostawcy, w tym opłat za wejście i wejście z cache. Zmierz energię całego systemu, razem z prefill. Dodaj modernizacje, energię bezczynności, utrzymanie i oczekiwaną wartość odsprzedaży. Porównuj zaakceptowaną pracę, ponieważ ponowienia i różnice jakości zmieniają koszt zadania.
Kiedy dodać pamięć
Wyjdź poza 16 GB, gdy zmierzone obciążenie przekracza dostępny kontekst przy akceptowalnej jakości i opóźnieniu. Codzienne długie sesje agentów, równoczesne żądania lub wagi o większej precyzji uzasadniają większą pojemność.
Dwie karty 16 GB wymagają jawnej obsługi runtime. Nie tworzą jednej przezroczystej alokacji 32 GB. Każde urządzenie potrzebuje buforów, a komunikacja używa interkonektu hosta.
| Strategia podziału | Główny kompromis |
|---|---|
| Podział warstw | Różne warstwy zajmują różne urządzenia |
| Podział tensorów lub wierszy | Praca wewnątrz warstw dodaje komunikację |
| CPU plus GPU | Większa pojemność z innym profilem opóźnienia |
Druga karta ma sens, gdy płyta główna, zasilacz, chłodzenie i backend już obsługują plan. Porównaj pełny koszt systemu z większą pojedynczą GPU. Poradnik sprzętowy Qwen 32 GB omawia te alternatywy.
Rozwiązywanie problemów i następne kroki
Jeśli ładowanie się nie uda, zmniejsz kontekst i sprawdź alokacje. Jeśli szybkość spada podczas sesji, sprawdź zajęty kontekst i offload CPU. Jeśli pierwsza odpowiedź się zatrzymuje, zmierz zimny prefill. Jeśli użycie narzędzi psuje się po kompresji, porównaj to samo zadanie z modelem o większej precyzji.
Zapisz powtarzalny test z normalnymi instrukcjami, plikami i wynikami narzędzi. Zapisz rewizję modelu, wersję runtime, precyzję cache, zajęty kontekst, szczyt pamięci, opóźnienie pierwszego tokena, szybkość decode oraz wynik zadania. Powtórz test w pobliżu najdłuższej oczekiwanej sesji.
Użyj poradnika lokalnych modeli i kontekstu , aby porównać mniejsze alternatywy. Wybierz najmniejszy model spełniający wymagania jakościowe, a potem zarezerwuj pamięć na całe zadanie. W tych warunkach 16 GB to użyteczny cel dla stacji roboczej.
Related Posts