2x RTX 5060 Ti kontra GB10: Dlaczego 32 GB VRAM przegrywa ze 128 GB pamięci współdzielonej
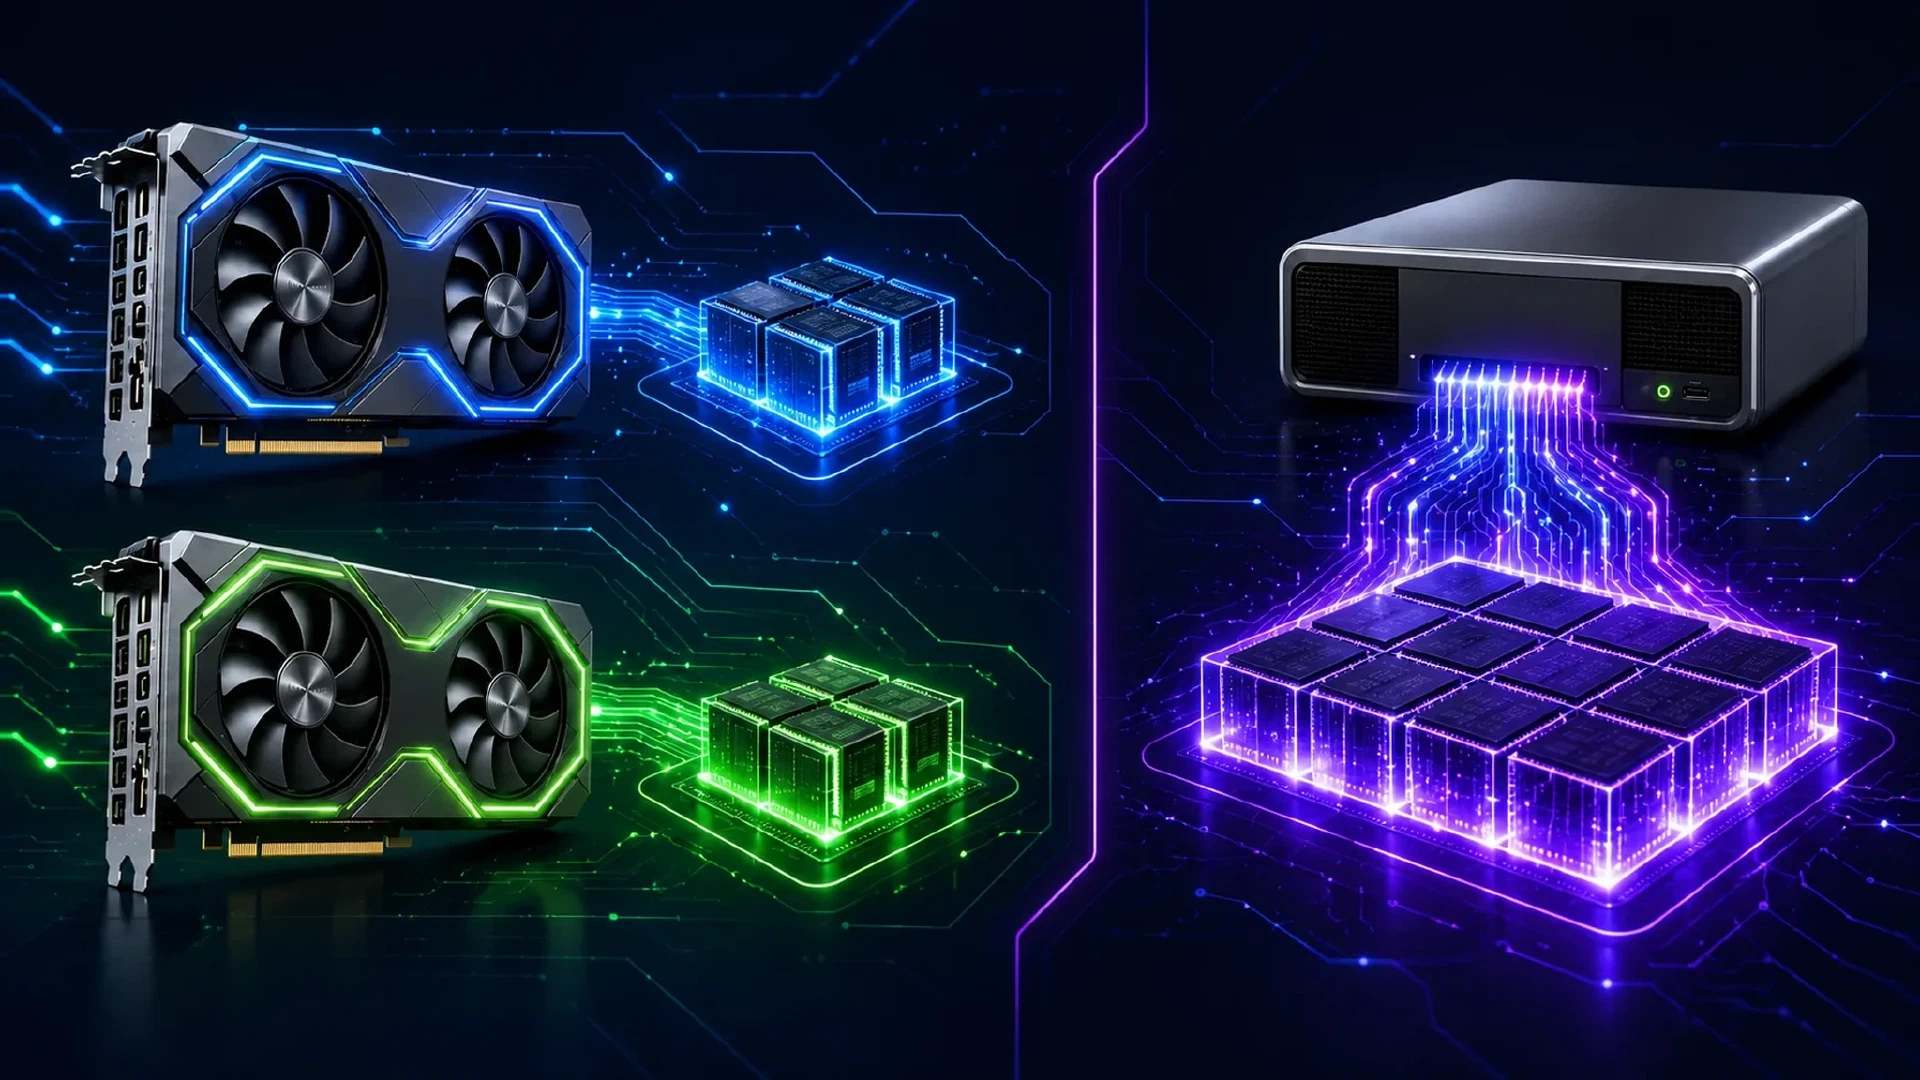
Table of Contents
Dwie karty RTX 5060 Ti 16 GB wyglądają atrakcyjnie na liście części. Oferują łącznie 32 GB VRAM i szybkie przetwarzanie promptów przy krótkim kontekście. Porównanie zmienia się przy uruchomieniu modelu 27B z długim kontekstem.
System NVIDIA GB10 używa 128 GB spójnej pamięci współdzielonej. NVIDIA podaje dla platformy GB10 128 GB pamięci LPDDR5x i TDP układu 140 W. RTX 5060 Ti używa 16 GB GDDR7 na kartę, interfejsu 128-bitowego i mocy grafiki 180 W. Specyfikacja NVIDIA RTX 5060 Ti oraz specyfikacja NVIDIA GB10 pokazują różnicę sprzętową.
Sedno jest proste. Dwie karty 16 GB nie tworzą jednego szybkiego puli 32 GB. Tworzą dwa osobne pule 16 GB połączone przez system hosta. Przy wnioskowaniu dużego modelu brak pojemności i przesyłanie danych między urządzeniami mają większe znaczenie niż liczba kart.
Porównanie pamięci
| System | Pamięć | Model pamięci | Podana moc |
|---|---|---|---|
| 2x RTX 5060 Ti 16 GB | 32 GB łącznie | Dwie osobne pule pamięci GPU | 360 W GPU łącznie |
| System GB10 | 128 GB | Spójna współdzielona pamięć systemowa | TDP GB10 140 W |
GB10 nie wygrywa dlatego, że 128 GB LPDDR5x dorównuje przepustowości wysokiej klasy dyskretnego GPU. Przewaga wynika z pojemności i rozmieszczenia. CPU i GPU współdzielą tę samą przestrzeń adresową, więc model, bufory runtime, aktywacje i dane kontekstu nie muszą mieścić się w dwóch odizolowanych urządzeniach 16 GB.
System z dwiema kartami ma trudniejsze rozmieszczenie danych. Model musi zmieścić się na obu kartach. Runtime wnioskowania musi przesyłać dane między nimi. Ruch PCIe dodaje opóźnienia i zużywa przepustowość. Według specyfikacji NVIDIA RTX 5060 Ti nie obsługuje też NVLink.
Wynik benchmarku
Poniższe wyniki pochodzą z dostarczonego raportu benchmarkowego AI. Raport porównuje nienazwany system dual-GPU oznaczony 5060ti-x2 z systemem GB10. Test obejmuje Qwen i GPT-OSS przy wielu rozmiarach kontekstu.
Modele pochodziły bezpośrednio z Ollama. Test używał dosłownych domyślnych tagów qwen3.8:27b i gpt-oss:latest, bez własnego Modelfile i alternatywnej kwantyzacji. System 5060ti-x2 używał PCIe Gen4 x16 oraz najnowszych sterowników NVIDIA dla Linuksa dostępnych podczas benchmarku.
Przetwarzanie promptu i generowanie Qwen
| Kontekst | Prompt 5060ti-x2 tok/s | Generowanie 5060ti-x2 tok/s | Prompt GB10 tok/s | Generowanie GB10 tok/s |
|---|---|---|---|---|
| 4K | 862.5 | 56.9 | 57.4 | 27.7 |
| 16K | 917.3 | 53.5 | 62.1 | 28.1 |
| 32K | 881.4 | 48.8 | 62.4 | 26.9 |
| 64K | 795.1 | 39.6 | 59.9 | 26.1 |
| 128K | 538.7 | 28.3 | 59.9 | 28.6 |
| 256K | 189.9 | 1.2 | 59.9 | 25.8 |
Przy 4K system z dwiema kartami generuje około dwa razy szybciej niż GB10. Przy 64K przewaga spada do około 1,5 raza. Przy 128K systemy osiągają podobną szybkość generowania.
Przy 256K porównanie przestaje wyglądać jak zwycięstwo konfiguracji dwukartowej. Żądanie 5060ti-x2 osiągnęło tylko 171 359 rzeczywistych tokenów promptu. Generowanie spadło do 1,2 tokena na sekundę. GB10 ukończył pełny test 256K z prędkością 25,8 tokena na sekundę.
W przetestowanym wyniku 256K GB10 generował około 21,5 raza szybciej. Ważniejsze jest to, że GB10 ukończył żądany kontekst. System dwukartowy nie wykonał tego samego obciążenia.
Dlaczego łączna VRAM wprowadza w błąd
1. Model nie widzi jednej karty 32 GB
Dwa GPU nie łączą pamięci w jedną lokalną przestrzeń adresową. Runtime model-parallel dzieli warstwy lub tensory między urządzenia. Każde urządzenie nadal potrzebuje miejsca na przypisane wagi, bufory tymczasowe i część stanu kontekstu.
Użyteczna pojemność jest więc mniejsza niż sugeruje prosta suma. Dokładny narzut zależy od formatu modelu, kwantyzacji, backendu wnioskowania, podziału tensorów i długości kontekstu.
2. Pamięć kontekstu rośnie podczas generowania
Wagi modelu to tylko część budżetu pamięci. Key-value cache, czyli KV cache, przechowuje dane attention dla wcześniejszych tokenów. Dłuższe konteksty wymagają większej pamięci cache. Test 4K nie przewiduje wdrożenia 128K ani 256K.
Dostarczone wyniki wyraźnie pokazują tę granicę. System dwukartowy zachowuje dużą przewagę w przetwarzaniu promptu, a potem traci wydajność generowania wraz ze wzrostem kontekstu. GB10 utrzymuje około 26 do 29 tokenów generowania na sekundę od 4K do 256K.
3. Transfery PCIe dodają koszt
Gdy runtime przenosi aktywacje lub tensory między GPU, transfer przechodzi przez interkonekt hosta. Tworzy to punkty synchronizacji i dodaje opóźnienie do każdego kroku. Kara rośnie, gdy obciążenie wielokrotnie przekracza granicę urządzeń.
Nie czyni to systemu dual-GPU bezużytecznym. Rozmieszczenie pamięci wpływa na wynik wydajności. Benchmark pokazujący tylko przetwarzanie promptu przy 4K pomija ten koszt.
4. Efektywność energetyczna daje przewagę systemową
W porównaniu GB10 zużywa mniej energii, zapewniając większą pojemność pamięci dla testowanego obciążenia z długim kontekstem. Dwie karty RTX 5060 Ti mają łączną moc GPU 360 W przed uwzględnieniem reszty systemu. NVIDIA podaje TDP GB10 na poziomie 140 W.
GB10 wymienia szczytową szybkość przy krótkim kontekście na pojemność, ukończenie zadania i niższą moc GPU. Te kompromisy mają znaczenie przy wnioskowaniu Qwen z długim kontekstem.
System 5060ti-x2 kosztuje znacznie mniej
Porównanie wydajności nie usuwa różnicy cenowej. Kompletna stacja robocza z dwiema kartami RTX 5060 Ti 16 GB była wyceniona na $3,479 10 października 2026 roku. Konfiguracja obejmuje Intel Ultra 7 265K, płytę Z890, 32 GB DDR5, 1 TB pamięci masowej, zasilacz 1 000 W i obie karty. Zobacz pełną ofertę stacji dual-GPU .
Amerykański marketplace NVIDIA wycenia DGX Spark 128 GB na $6,950. Oferta obejmuje 128 GB spójnej pamięci współdzielonej i 4 TB NVMe, ale pokazuje brak towaru. Sprawdź bieżącą ofertę DGX Spark NVIDIA .
Platforma AMD Ryzen AI Halo Developer Platform daje kolejny punkt odniesienia. System Strix Halo kosztuje $3,999.99 w Micro Center i ma 128 GB współdzielonej pamięci LPDDR5x oraz 2 TB pamięci masowej. Strix Halo często trafia do tej samej praktycznej klasy lokalnego AI co systemy GB10, choć niezależne testy często mierzą przewagę GB10 w przepustowości i dojrzałości oprogramowania. Sprawdź bieżącą ofertę Micro Center dla Linuksa oraz przeczytaj recenzję Strix Halo kontra GB10 .
| Kompletny system | Cena z 10 października 2026 | Różnica ceny |
|---|---|---|
| Stacja 5060ti-x2 | $3,479 | Punkt bazowy |
| AMD Ryzen AI Halo, Strix Halo | $3,999.99 | $520.99 więcej |
| 128 GB GB10 DGX Spark | $6,950 | $3,471 więcej |
GB10 zapewnia większą pulę pamięci współdzielonej, niższe zużycie energii i lepszą architekturę dla długiego kontekstu. System AMD daje tę samą klasę 128 GB za około 4 000 USD. Stacja 5060ti-x2 kosztuje około 50% ceny GB10 przed podatkiem i wysyłką. Kupujący potrzebujący pamięci współdzielonej, lecz niepotrzebujący stosu oprogramowania NVIDIA, mają tańszą alternatywę w Strix Halo.
Są to ceny listowe od różnych sprzedawców, a nie kontrolowany koszyk detaliczny. Porównanie zostawia też system 5060ti-x2 z mniejszą pamięcią systemową i przestrzenią dyskową. Różnica nadal ma znaczenie, ponieważ obie oferty opisują kompletne, użyteczne komputery, a nie same GPU. Bieżące oferty kart RTX 5060 Ti 16 GB wynoszą około $789 do $830 za sztukę, znacznie powyżej MSRP startowego $429. Przewaga cenowa dwóch kart utrzymuje się więc nawet podczas obecnego wzrostu cen GPU. Bieżące sprawdzenie cen RTX 5060 Ti .
Wynik GPT-OSS wymaga osobnego omówienia
Ten sam raport pokazuje dobre wyniki generowania 5060ti-x2 dla GPT-OSS od 4K do 256K. GB10 kończy testy od 4K do 128K, lecz test GPT-OSS 256K oznaczono jako unsupported.
Nie używaj tabeli GPT-OSS do twierdzenia o uniwersalnym zwycięzcy. Testy nie obejmują tego samego zakresu przy 256K. Wynik Qwen daje czystsze porównanie długiego kontekstu, ponieważ oba systemy raportują wynik 256K, choć uruchomienie 5060ti-x2 osiągnęło tylko 171 359 rzeczywistych tokenów promptu.
Co to oznacza dla konfiguracji Qwen 3 27B
Konfiguracja z dwiema kartami 16 GB może uruchomić kwantyzowany model 27B przy mniejszym kontekście. Benchmark nie obala takiego zastosowania. Dane obalają twierdzenie, że 32 GB łącznej VRAM daje taką samą praktyczną rezerwę jak system ze 128 GB pamięci współdzielonej.
Zmieszczenie modelu na karcie dowodzi tylko pojemności na wagi. Rzeczywiste zapotrzebowanie to wagi modelu plus aktywny kontekst, KV cache, bufory runtime i rezerwa systemu operacyjnego. Kontekst musi zmieścić się obok modelu. Model, który się ładuje, lecz nie ma miejsca na bieżącą rozmowę, nie jest użyteczną konfiguracją z długim kontekstem.
Jest to zgodne ze wskazówkami doboru rozmiaru w Czy 16 GB VRAM wystarcza do poważnej pracy z lokalnymi LLM? , które traktują wagi, kontekst i alokacje runtime jako jeden budżet. Przewodnik 32 GB VRAM dla Qwen 27B dochodzi do tego samego wniosku dla konfiguracji dwukartowych. Łączna pojemność nie równa się użytecznej rezerwie.
Przed zakupem sprzętu do wdrożenia Qwen 3 27B zadaj cztery pytania:
- Czy wymagana kwantyzacja mieści się wraz z buforami runtime? Same wagi modelu nie określają zapotrzebowania na pamięć.
- Czy kontekst mieści się bez dużego nacisku na KV cache? Długie prompty zmieniają wynik.
- Czy runtime używa szybkiego podziału urządzeń? Transfery PCIe i rozmieszczenie tensorów wpływają na każdy wygenerowany token.
- Czy system kończy docelowy kontekst? Szybki wynik 4K nie równoważy nieudanego obciążenia 256K.
Dostarczony test odpowiada na ostatnie pytanie dla systemu dwukartowego. Uruchomienie osiągnęło 171 359 tokenów podczas żądania Qwen 256K i generowało z prędkością 1,2 tokena na sekundę. GB10 ukończył 256K z prędkością 25,8 tokena na sekundę.
Dla tego obciążenia z długim kontekstem pamięć współdzielona jest lepszą architekturą, gdy alternatywa używa PCIe do objęcia roboczego zbioru modelu. PCIe pozostaje obejściem pojemnościowym. PCIe nie tworzy tej samej puli pamięci, opóźnienia ani ścieżki transferu. Przewodnik po kontekście GPU dla lokalnego AI wyjaśnia, dlaczego wagi modelu, KV cache, wynik narzędzi i bufory runtime trzeba dobierać razem. Benchmark GPU Ollama Qwen3.8 27B pokazuje też, dlaczego wyniki długiego kontekstu wymagają osobnej uwagi niż liczby dekodowania przy krótkim kontekście.
Werdykt
Dwie karty RTX 5060 Ti 16 GB są słabym zamiennikiem GB10, gdy celem jest wnioskowanie 27B z długim kontekstem. Dają większą przepustowość promptu przy krótkich kontekstach. Zużywają też więcej mocy GPU i wystawiają runtime na układ z podzieloną pamięcią.
GB10 jest wolniejszy w przetwarzaniu promptu w dostarczonych wynikach. System jest bardziej energooszczędny, oferuje czterokrotnie większą łączną pamięć i kończy pełny test Qwen 256K z użyteczną szybkością generowania.
Jeśli uruchamiasz krótkie prompty i cenisz wczytywanie promptu, 5060ti-x2 ma wąskie zastosowanie. Dla modelu 27B lepszym wyborem jest większa pula pamięci współdzielonej, ponieważ model i kontekst korzystają ze spójnego zbioru roboczego. Pamięć współdzielona pozostaje lepsza po wejściu transferów PCIe do ścieżki wnioskowania.
Benchmark nie pokazuje, że dwie karty RTX 5060 Ti nigdy nie uruchomią Qwen 3 27B. Dane pokazują, dlaczego uruchomienie modelu różni się od dobrego wykonania obciążenia.
Ograniczenia benchmarku
Dostarczony raport podaje dosłowne tagi Ollama, lecz nie zapisuje rozstrzygniętych skrótów manifestów, wersji modeli, CPU, pomiarów mocy ani chłodzenia. Raport podaje też PCIe Gen4 x16 dla systemu 5060ti-x2 i bieżące sterowniki NVIDIA dla Linuksa w czasie testu. Traktuj liczby jako zaobserwowane porównanie systemów, nie uniwersalny ranking każdej pary RTX 5060 Ti i każdej implementacji GB10.
Powyższe specyfikacje sprzętu pochodzą od NVIDIA. Dane wydajności pochodzą z danych benchmarku dostarczonych dla tego artykułu.
Źródła
- Biblioteka modeli Ollama Qwen3.8
- Tagi modeli Ollama GPT-OSS
- Czy 16 GB VRAM wystarcza do poważnej pracy z lokalnymi LLM?
- 32 GB VRAM dla Qwen 27B
- Przewodnik po kontekście GPU dla lokalnego AI
- Benchmarki GPU Qwen3.8 27B na Vast.ai
- Oferta stacji roboczej z dwiema kartami RTX 5060 Ti 16 GB
- Oferta NVIDIA DGX Spark w marketplace US
- Oferta AMD Ryzen AI Halo 128 GB dla Linuksa
- Recenzja Tom’s Hardware Strix Halo kontra GB10
- Bieżące ceny RTX 5060 Ti
Related Posts