Nasza hybrydowa flota agentów AI od środka: Hermes, LiteLLM i Tailscale

Table of Contents
Uruchomiliśmy lokalną flotę GPU przydzielającą zasoby dla poszczególnych żądań i zaprojektowaliśmy jej hybrydową płaszczyznę sterowania. Zweryfikowana ścieżka zaczyna się w LiteLLM, wybiera grupę modeli i ładuje lokalny model na jednym GPU naraz. Polityka poziomów Hermes jest propozycją, a artefakt konfiguracji Tailscale Aperture czeka na kolejny test integracyjny. Nie zweryfikowaliśmy, czy którykolwiek z tych elementów uczestniczy w jednej ścieżce end-to-end.
Bezczynne karty kopią Pearl. Żądanie AI wstrzymuje mining tylko na wydzierżawionej karcie, obsługuje żądanie, wyładowuje model i zwraca kartę do minera.
Najważniejsze wnioski
- T0–T2 obsługują kosztowne lub wymagające zadania. Te ścieżki preferują hostowane modele frontier i uporządkowane łańcuchy awaryjne.
- T3 obsługuje znaczną część pracy lokalnej. Flota przypisuje planowanie, kodowanie, przegląd i wizję modelom od 4B do 12B.
- T4 obsługuje częste zadania lokalne o dużej liczbie wywołań. Małe modele kierują, klasyfikują, wyodrębniają, tworzą embeddingi i realizują ograniczone zadania kodowe.
- Każde GPU jest niezależnym zasobem. Jedna karta obsługuje AI, a pozostałe nadal kopią.
- Lokalne modele pozostają wyładowane w czasie bezczynności. Żaden model nie zajmuje pamięci GPU między oknami żądań.
- Każda brama udostępnia ten sam logiczny katalog. Współdzielone aliasy rozdzielają pracę między kwalifikujące się systemy. Alias z prefiksem węzła zachowuje dokładne przypisanie, gdy jest potrzebne.
- Eksperymentalny broker nie trafił do produkcji. Jego canary obsłużyło żądanie, a potem nie przeszło testu czystego zamknięcia. LiteLLM pozostał na zweryfikowanej ścieżce obsługi żądań.
- Hermes i Aperture pozostają na etapie przygotowania. Projekt docelowy istnieje, ale testy akceptacyjne end-to-end pozostają otwarte.
Wymagania wstępne: kilka hostów Linux z GPU, stabilne sterowniki NVIDIA, tailnet Tailscale, systemd, działający miner, magazyn modeli i testy akceptacyjne dla każdej trasy modelu.
Czas i trudność: poziom zaawansowany. Zaplanuj kilka dni na inwentaryzację, pobieranie modeli, definicje usług, testy routingu, ćwiczenia awarii i kontrole przywracania miningu dla każdej karty.
Użyte pojęcia: tailnet to sieć prywatna utworzona przez tożsamości i urządzenia Tailscale. Alias modelu to stabilna nazwa widoczna dla klientów. Grupa modeli umieszcza kilka wdrożeń za jednym aliasem. Proxy puli to mała lokalna usługa, która dzierżawi GPU, uruchamia worker modelu, a potem zwraca kartę do miningu.
Cel projektu
Zadania agentowe mają różne formy. Naprawa repozytorium wymaga innego modelu niż tytuł, zrzut ekranu, embedding czy etykieta intencji. Kierowanie każdej tury do największego modelu marnuje pieniądze i lokalne zasoby. Kierowanie każdej tury do najmniejszego modelu powoduje ponowienia i słabe wyniki.
Chcieliśmy mieć jeden katalog z pięcioma pasmami obciążenia. Polityka miała obsługiwać modele hostowane i lokalne przez znane formaty API. Lokalne GPU miały pozostać użyteczne między żądaniami AI.
Flota musiała też obsługiwać współbieżność. Host z wieloma kartami powinien równolegle wykonywać kilka niezależnych zadań. Żądanie na jednej karcie nie powinno zatrzymywać miningu na wszystkich kartach w obudowie.
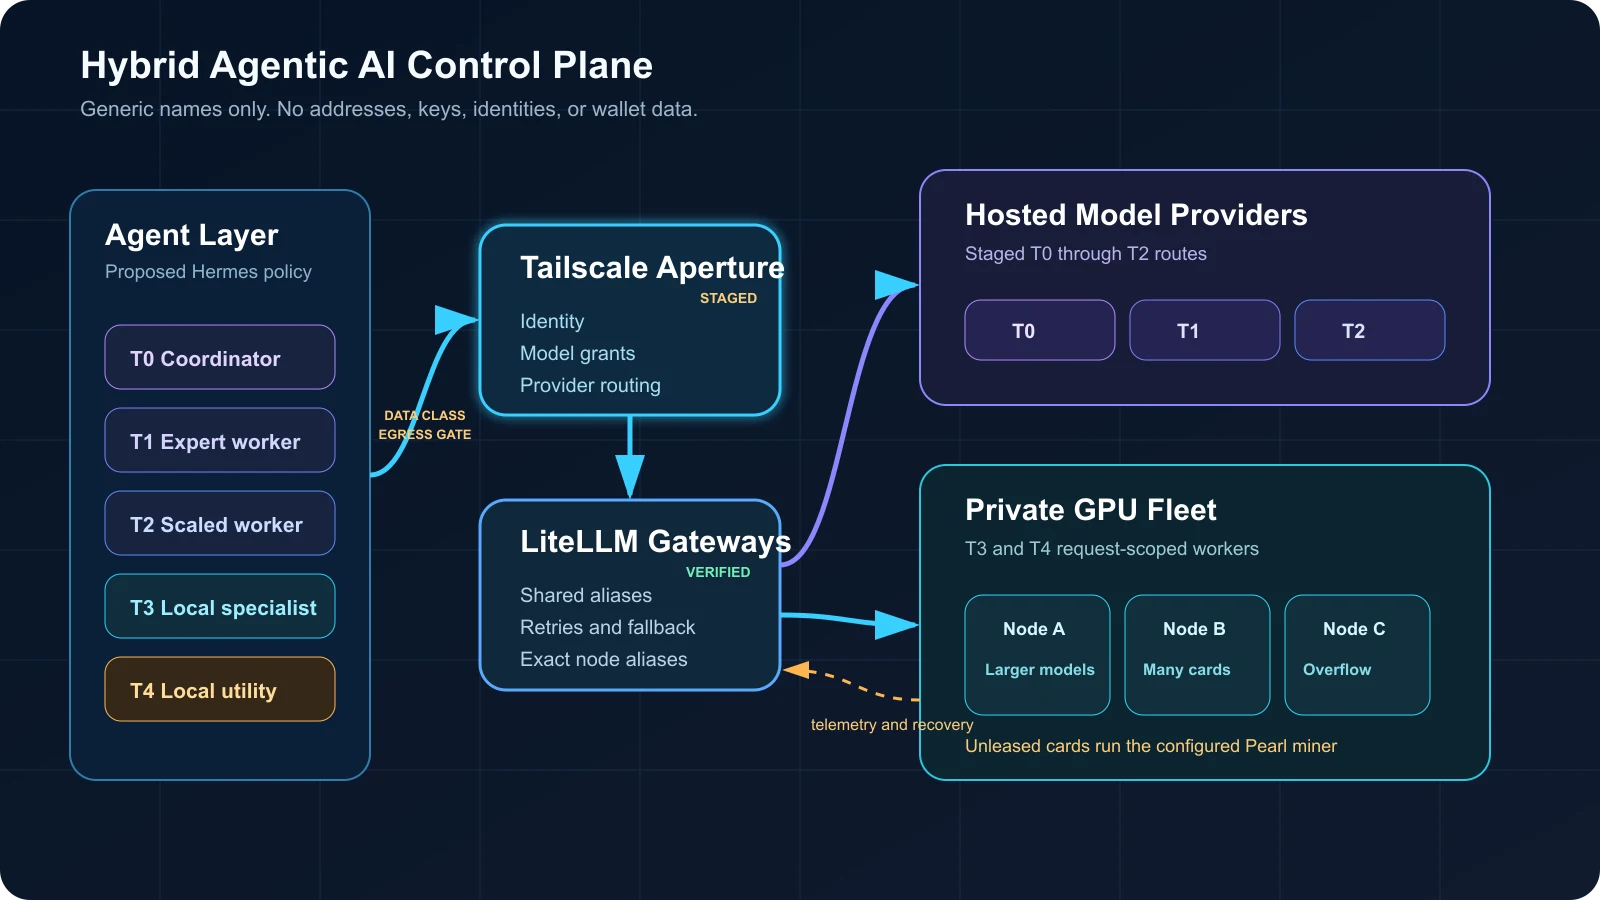
Proponowana i przygotowana ścieżka sterowania znajduje się nad zweryfikowaną ścieżką LiteLLM i wykonywania zadań na poszczególnych GPU
Diagram używa ogólnych nazw węzłów. Pomija prywatne adresy, tożsamości użytkowników, klucze dostępu, dane portfeli i nazwy fizycznych hostów.
Co oznaczają poziomy T0–T4
Nazwy poziomów opisują naszą politykę routingu. Nie są standardem branżowym i nie określają wyłącznie rozmiaru modelu.
| Poziom | Główna rola | Typowy cel | Działanie po awarii |
|---|---|---|---|
| T0 | Domyślny koordynator i najtrudniejsze decyzje | Hostowany model frontier do rozumowania | Uporządkowany hostowany łańcuch awaryjny |
| T1 | Agenci roboczy o dużej wartości | Hostowana pula modeli o wysokich możliwościach | Ponowienie w przypisanym łańcuchu |
| T2 | Szeroka pula agentów roboczych | Szybkie modele hostowane z eskalacją | Eskalacja trudnego zadania do T1 lub T0 |
| T3 | Znaczna część prywatnej pracy lokalnej | Lokalne modele czatu, kodowania, przeglądu i wizji od 4B do 12B | Ponowienie na kwalifikującym się węźle lokalnym, a następnie bezpieczne przerwanie dla danych o ograniczonym dostępie |
| T4 | Częsta, wąsko określona praca lokalna | Modele od 0,6B do 3B do routingu, klasyfikacji, kodu i embeddingów | Ponowienie na lokalnej replice lub przejście do T3 w obrębie tej samej granicy danych |
Poziomy najpierw opisują zadanie, a dopiero potem model. Krótka klasyfikacja wrażliwa z punktu widzenia bezpieczeństwa pasuje do T4. Długi plan prac nad repozytorium należy do T3 lub wyżej. Trudna decyzja architektoniczna zaczyna się na wyższym poziomie, nawet przy krótkim promptcie.
Ten podział zmienia też ekonomię agentów. Workery T4 przejmują powtarzalne transformacje niskiego ryzyka. Workery T3 utrzymują typowy kod i analizę w tailnecie. T0–T2 pozostają dostępne dla trudnych zadań i odzyskiwania po awarii.
Kontrola klasy danych musi poprzedzać każdy hostowany fallback. Zadania publiczne, wewnętrzne i o ograniczonym dostępie otrzymują oddzielne łańcuchy. Zadania ograniczone pozostają lokalne i kończą się bezpiecznym przerwaniem. Ponowienie przekraczające granicę wymaga oczyszczonego wejścia i jawnej zgody użytkownika lub przepływu pracy. Przed wywołaniem hostowanym redakcja usuwa dane uwierzytelniające, sekrety repozytorium, prywatne wyniki narzędzi i wrażliwe treści pobrane z zasobów.
Jak Hermes ma zarządzać polityką zadań
Hermes to proponowana warstwa agentowa. Polityka docelowa przypisuje klasę modelu, uruchamia narzędzia, deleguje pracę i przechodzi przez jawne łańcuchy awaryjne. Hermes dokumentuje osobne trasy dla modelu głównego, zadań pomocniczych, agentów delegowanych i fallbacków zależnych od zadania. Obsługuje też niestandardowe endpointy zgodne z OpenAI przez bazowy URL. Zobacz przewodnik konfiguracji Hermes oraz przewodnik po dostawcach awaryjnych .
Nasza polityka mapuje zadania Hermes na stabilne aliasy, a nie fizyczne serwery. Przykłady:
t3-smart
t3-code
t3-review
t3-vision
t4-code
t4-classify
t4-router
t4-embedding
Alias określa cel. Hermes nie musi wiedzieć, które GPU jest wolne, który węzeł ma większą kartę ani która replika nie przeszła kontroli stanu. Tymi decyzjami zajmują się niższe warstwy.
Część zadań nadal wymaga deterministycznego przypisania. Identyfikator modelu z prefiksem węzła kieruje diagnostykę operatora lub benchmark do wybranego systemu. Osobne granty Aperture powinny ograniczać te aliasy do operatorów. Zwykły ruch agentów korzysta ze współdzielonych aliasów poziomów.
Dostęp do modelu nie zabezpiecza narzędzi agenta. Wdrożenie Hermes wymaga list dozwolonych narzędzi o minimalnych uprawnieniach, izolowanych obszarów roboczych, ograniczonych poświadczeń, kontroli ruchu wychodzącego z sieci i obsługi wstrzykiwania promptów. Agenci delegowani nie powinni dziedziczyć większego dostępu, niż wymaga przypisane zadanie.
Aperture jako przygotowana granica tożsamości
Tailscale łączy skonfigurowaną bramę i hosty wnioskowania bez publikowania każdej usługi w publicznym Internecie. Aperture jest przygotowane jako granica dla użytkownika i router modeli. Ta trasa wymaga jeszcze testu akceptacyjnego end-to-end. Tailscale dokumentuje szyfrowany dostęp klienta przez tailnet i przekazywanie do dostawcy przez TLS w artykule Jak działa Aperture .
Aperture rozdziela też osiągalność od uprawnień. Granty domyślnie odmawiają dostępu. Po dotarciu do bramy użytkownik lub oznaczone urządzenie potrzebuje pasującego grantu modelu. Przewodnik po grantach Aperture opisuje addytywny model grantów i źródła tożsamości.
Przed wdrożeniem przygotowana konfiguracja Aperture powinna spełniać cztery zasady:
- Jedna nazwana tożsamość ma rolę administratora. Ogólny dostęp do modeli nie przyznaje uprawnień administracyjnych.
- Dostawcy podają dosłowne identyfikatory modeli. Aperture nie wywnioskuje modeli z usługi upstream.
- Adresy URL dostawców wskazują adresy tailnetu. Prywatne nazwy i adresy węzłów nie trafiają do artykułu ani publicznych przykładów konfiguracji.
- Sekrety pozostają w plikach należących do usługi. Przed wdrożeniem zastosuj uprawnienia tylko dla właściciela, ograniczone konta usługowe, rotację i redakcję logów. Wyniki diagnostyczne nigdy nie mogą drukować kluczy LiteLLM, adresów tailnetu, tokenów subskrypcji ani danych portfela.
Aperture dopisuje ścieżkę żądania przychodzącego do bazowego URL każdego dostawcy.
Dokumentacja konfiguracji
ostrzega przed umieszczaniem powielonego sufiksu /v1 w bazowym adresie dostawcy. Ten szczegół powodował wystarczające ryzyko integracji, by dodać osobny test walidacyjny.
Wizja jest przygotowana do przechodzenia przez format OpenAI Chat Completions z treścią obrazu. Embeddingi korzystają bezpośrednio z prywatnego endpointu LiteLLM, ponieważ aktualna macierz samodzielnie hostowanych dostawców Aperture dokumentuje formaty czatu, a nasza ścieżka embeddingów zależy od endpointów LiteLLM i llama.cpp poza wyborem czatu. Zobacz referencję obsługiwanych dostawców i klientów .
Bezpośrednia ścieżka embeddingów potrzebuje własnej granicy autoryzacji. Uwierzytelnianie LiteLLM, restrykcyjne granty Tailscale, powiązanie usługi z interfejsem tailnetu i reguły zapory hosta powinny ograniczać dostęp do zatwierdzonych tożsamości lub tagów usług. Sam prywatny adres nie jest polityką autoryzacji.
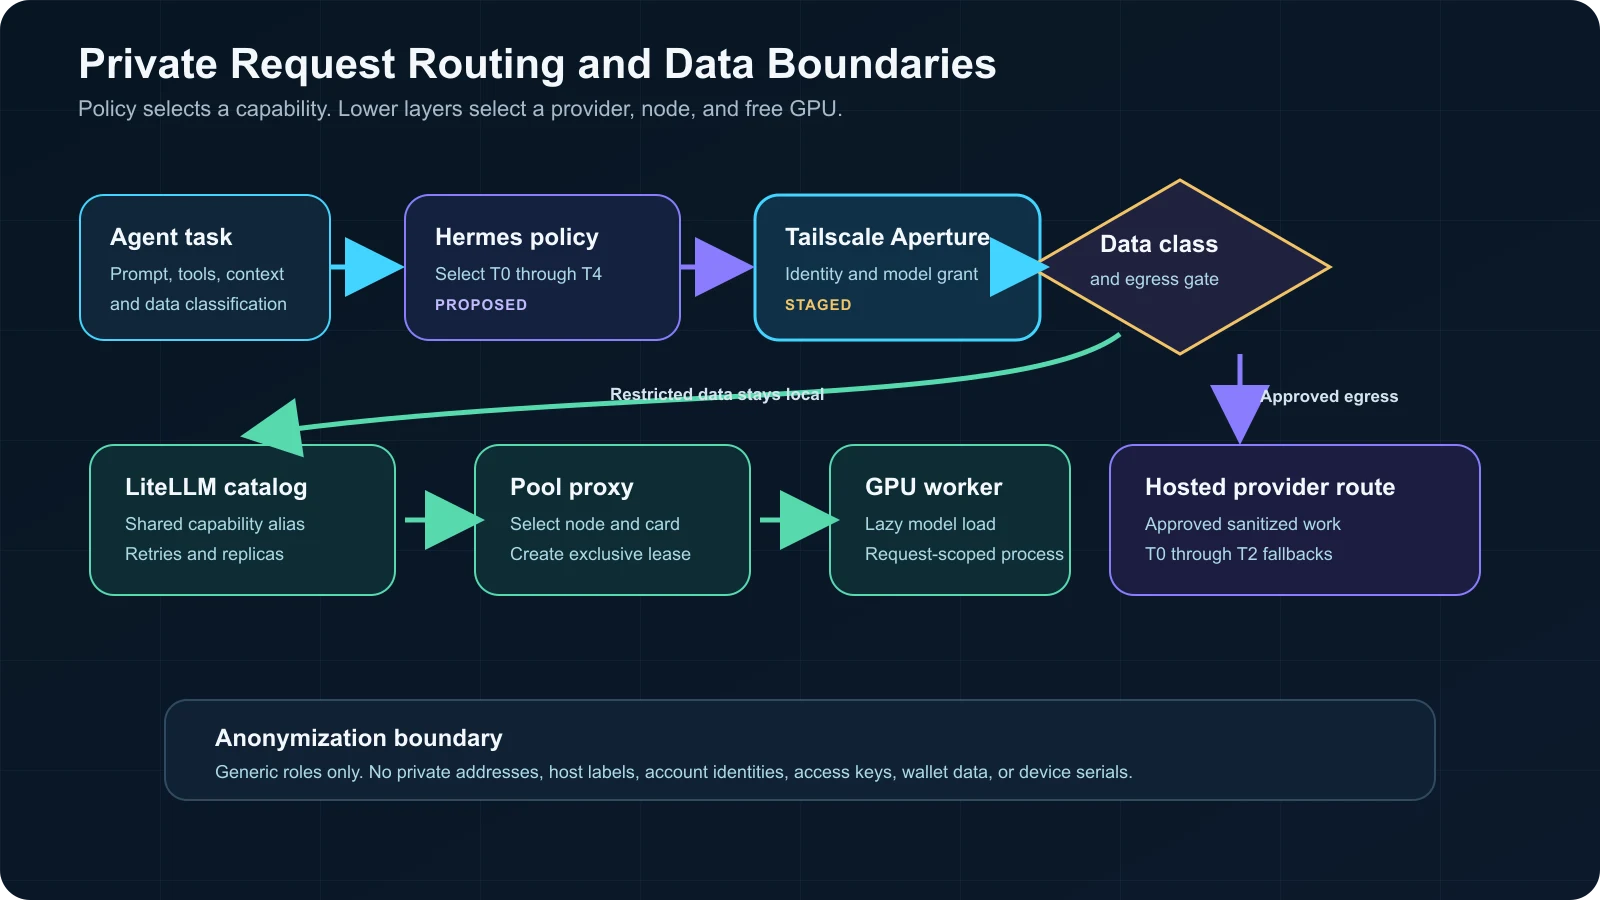
Tożsamość, granty i klasyfikacja danych decydują, czy żądanie opuszcza prywatną flotę
LiteLLM udostępnia jeden katalog
Każdy host wnioskowania uruchamia bramę LiteLLM. Wszystkie bramy udostępniają ten sam logiczny katalog modeli, nawet gdy model działa na innym węźle. Klient zachowuje jeden format API i jeden zestaw aliasów.
LiteLLM grupuje kilka wdrożeń pod jedną nazwą modelu. Router wybiera potem kwalifikujące się wdrożenie i stosuje ponowienia, limity czasu, okresy wyciszenia lub fallbacki. Aktualna dokumentacja routingu LiteLLM opisuje współdzielone nazwy modeli, strategie routingu i zachowanie ponowień.
Katalog ma dwa style adresowania:
| Styl adresowania | Przykład | Zastosowanie |
|---|---|---|
| Współdzielony alias | t4-classify |
Rozkładanie zwykłej pracy na kwalifikujące się węzły |
| Alias węzła | node-b/qwen-small |
Diagnostyka lub zachowanie przypisania |
Współdzielone aliasy zapewniają skalowanie poziome bez zmian w Hermes. Dodanie kwalifikującej się repliki rozszerza grupę modeli. Usunięcie niezdrowej repliki ją zawęża.
Logikę cyklu życia GPU utrzymujemy poniżej LiteLLM. Brama pozostaje aktywna, ponieważ jej pamięć nie rezerwuje pamięci GPU. Lokalny proxy puli odbiera żądanie wybranego modelu, dzierżawi kartę, uruchamia worker i zatrzymuje go po odpowiedzi.
Lokalny katalog modeli
Flota preferuje modele o rozmiarze do 12B parametrów. Ta granica pasuje do dostępnej pamięci kart, pozostawiając miejsce na kontekst i bufory środowiska wykonawczego.
Notacja modeli: B oznacza miliardy parametrów. K oznacza tysiące skonfigurowanych tokenów kontekstu. Kwantyzacja zapisuje wagi modelu z mniejszą precyzją liczbową, by zmniejszyć zużycie pamięci. Pamięć podręczna KV przechowuje stan uwagi dla aktywnego kontekstu i rośnie wraz z długością promptu. E4B to oznaczenie mniejszej wersji Gemma 4 stosowane przez Google.
| Trasa poziomu | Klasa modelu | Skonfigurowany kontekst | Główne zadanie | Umiejscowienie |
|---|---|---|---|---|
| T3 smart | Qwen3.5 9B, po kwantyzacji | 64K | Trudne lokalne planowanie i ogólna praca agentów | Węzły GPU z większą pamięcią |
| T3 kod | Granite 4.2 8B, po kwantyzacji | 64K | Praca z repozytorium, narzędzia, terminal i ustrukturyzowane wyniki | Węzły GPU z większą pamięcią |
| T3 przegląd | Gemma 4 12B, po kwantyzacji | 32K | Niezależny przegląd i alternatywne rozumowanie | Węzły GPU z większą pamięcią |
| T3 ogólny i wizja | Qwen3.5 4B, po kwantyzacji | 32K | Skalowalna praca ogólna i rozumienie obrazów | Każde zgodne GPU |
| T3 alternatywny przegląd | Gemma 4 E4B, po kwantyzacji | 8K | Zróżnicowana ścieżka przeglądu | Każde zgodne GPU |
| T4 kod | Granite 4.2 3B, po kwantyzacji | 16K | Drobne zmiany, wywołania narzędzi, ustrukturyzowane wyniki | Każde zgodne GPU |
| T4 klasyfikacja | Qwen3.5 2B, po kwantyzacji | 16K | Klasyfikacja, ekstrakcja i przepisywanie | Każde zgodne GPU |
| T4 router | Qwen3.5 0.8B, kwantyzacja wysokiej precyzji | 16K | Intencje, etykiety, tytuły i krótkie transformacje | Każde zgodne GPU |
| T4 embedding | Qwen3 Embedding 0.6B, po kwantyzacji | 32K | Pamięć agentów, RAG, wyszukiwanie kodu i grupowanie | Każde zgodne GPU |
Te wartości kontekstu są ustawieniami wdrożenia, a nie reklamowanymi limitami modeli. Większe deklarowane okno nadal zużywa pamięć KV i pamięć środowiska wykonawczego. Ustawiliśmy niższe wartości, by zapewnić stabilną pracę na jednej karcie.
Qwen opisuje Qwen3.5 jako rodzinę multimodalną i publikuje małe oraz większe warianty dense w kolekcji Qwen3.5 . IBM publikuje wyniki agentowego kodowania i długiego kontekstu dla Granite 4.2 8B . Google wymienia wejście multimodalne, wywoływanie funkcji i większe reklamowane okno dla Gemma 4 .
Trasa embeddingów używa osobnego modelu zamiast prosić model czatu o wektory. Karta modelu Qwen3 Embedding 0.6B podaje długość sekwencji 32K, wielojęzyczne wyszukiwanie, wyszukiwanie kodu i wymiary wyjściowe do 1 024.
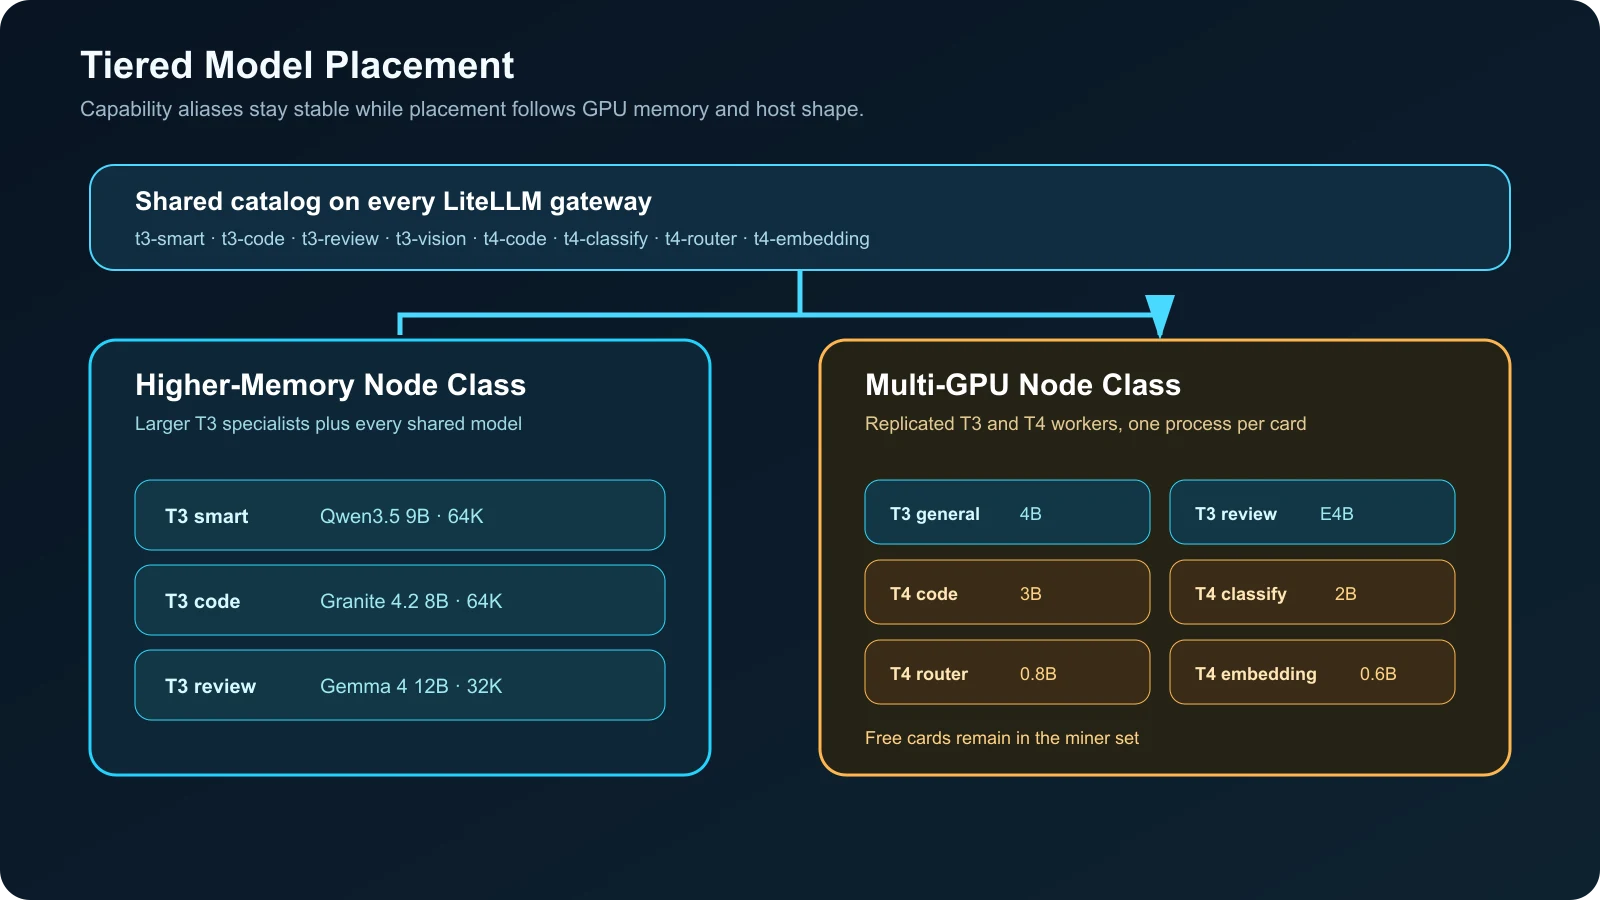
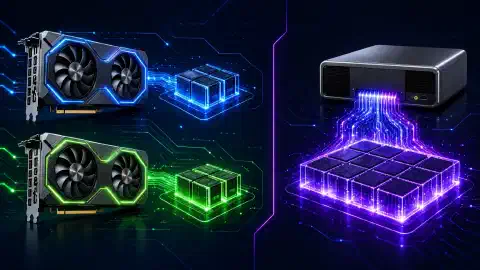
Więksi specjaliści pozostają na kartach o większej pamięci, a mniejsi są replikowani w całej flocie
Dlaczego llama.cpp działa w produkcji
llama.cpp pasuje do modelu zasobów. Jeden statyczny worker odpowiada jednemu GPU, jednemu plikowi modelu, jednemu skonfigurowanemu kontekstowi i jednej dzierżawie. Granica procesu ułatwia audyt uruchomienia, zatrzymania, widoczności GPU i logów.
Serwer udostępnia zgodne z OpenAI trasy czatu, odpowiedzi i embeddingów. Obsługuje też równoległe dekodowanie i ciągłe grupowanie zadań. Aktualna dokumentacja serwera określa obsługę multimodalną jako eksperymentalną. Funkcje opisano w dokumentacji serwera llama.cpp .
Ollama pozostaje ścieżką zgodności na większym węźle. Gdy pamięć na to pozwala, obsługuje równoczesne ładowanie modeli i natychmiastowe wyładowanie przez keep_alive: 0, zgodnie z
FAQ Ollama
. Nie wybraliśmy Ollama do produkcyjnej ścieżki na kartę, ponieważ statyczne workery llama.cpp zapewniły nam ściślejszą kontrolę przypisania i zamykania.
Sprawdziliśmy też Strata. Strata jest przeznaczona dla dużego modelu Qwen typu mixture-of-experts, rozłożonego na pamięć GPU, pamięć RAM i dysk. Opublikowane presety zaczynają się od 32 GB łącznej pamięci, a tryb low-RAM wymienia szybkość na mniejszą pojemność. Zobacz repozytorium Strata . Strata odpowiada innemu celowi: jednemu większemu modelowi hybrydowemu działającemu na jednej lub kilku kartach. Nasza flota stawia na wiele niezależnych workerów poniżej 12B.
Leniwe ładowanie na każdym GPU
Leniwe ładowanie dotyczy każdego workera modelu. Między żądaniami system utrzymuje aktywne tylko bramy, proxy puli, watchdogi i minera.
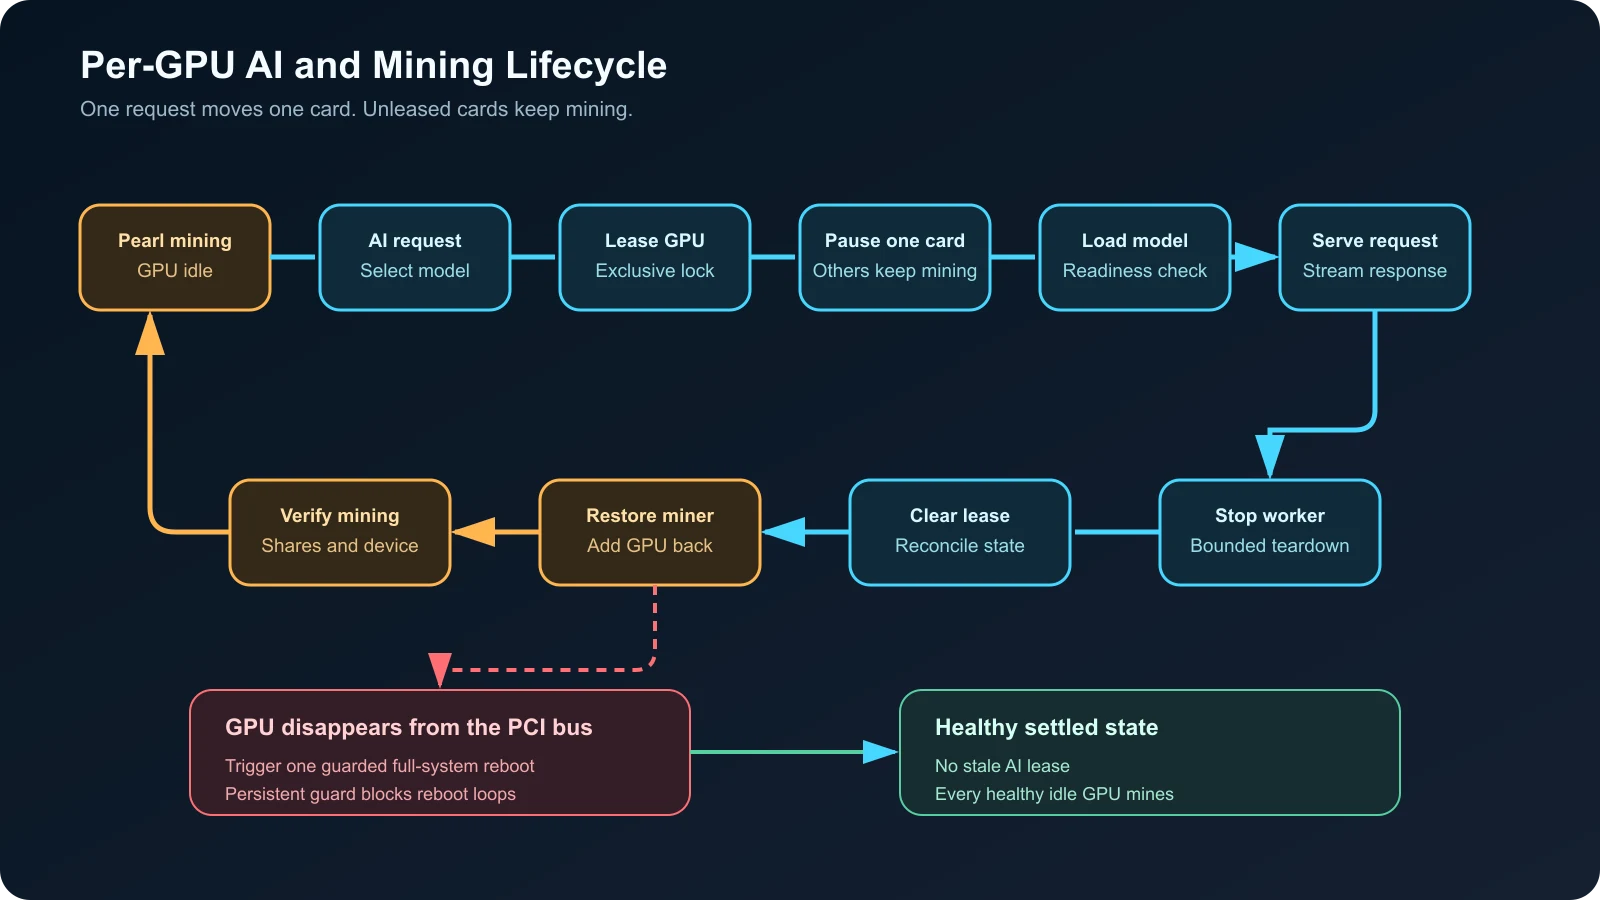
Tylko dzierżawiona karta opuszcza minera i wraca po zakończeniu procesu modelu
Cykl żądania obejmuje następujące kroki:
- LiteLLM wybiera wdrożenie. Żądanie trafia do proxy puli przypisanego wybranej klasie modelu.
- Pula uzyskuje dzierżawę. Blokada uniemożliwia dwóm wyłącznym workerom zajęcie tej samej karty.
- Miner uruchamia się ponownie bez jednego GPU. Każda niedzierżawiona karta pozostaje w poleceniu Pearl.
- llama.cpp uruchamia się na dzierżawionym urządzeniu. Kontrole gotowości kończą się, zanim proxy przekaże żądanie.
- Worker obsługuje odpowiedź. Równoczesne żądania uruchamiają workery na innych wolnych kartach.
- Worker kończy działanie. Pula usuwa dzierżawę po zakończeniu procesu.
- Miner uruchamia się ponownie ze zwolnionym GPU. Kontrole stanu potwierdzają, że karta wróciła do miningu.
To różni się od przełączania całego hosta. Obudowa z wieloma kartami obsługuje kilka modeli, a pozostałe karty wciąż kopią. Bezczynna flota zwraca wszystkie sprawne GPU do Pearl.
Whitepaper Pearl opisuje jego system dowodu obliczeń macierzowych. Nasza architektura nie zależy od prognoz rentowności ani twierdzeń o zysku ekonomicznym. Mining jest skonfigurowanym zadaniem bezczynności.
Obsługa awarii ma większe znaczenie niż start
Uruchomienie modelu to tylko połowa cyklu życia. Wymuszone zatrzymania, znikające GPU, przerwane żądania, przeterminowane dzierżawy i restarty minera wymagają jawnej obsługi.
Nasz watchdog porównuje skonfigurowany zestaw GPU z aktywną listą urządzeń NVIDIA. Potwierdzony brak GPU uruchamia jeden zabezpieczony restart całego systemu. Bezpieczny wyzwalacz produkcyjny powinien wymagać wielu nieudanych kontroli, okresu wyciszenia, opróżnienia aktywnych zadań, trwałego licznika restartów i zdalnego alertu. Nieudane odzyskiwanie powinno zatrzymać automatyzację i wymagać ręcznej interwencji.
Ten sam watchdog uzgadnia przeterminowane dzierżawy. Jeśli żaden worker nie jest właścicielem dzierżawy, uzgadnianie usuwa stary rekord i zwraca GPU do minera. Ta ścieżka naprawcza była ważna podczas testu canary brokera.
| Awaria | Reakcja |
|---|---|
| Model nie przechodzi kontroli gotowości | Zatrzymać workera, zwolnić dzierżawę, przywrócić mining i zwrócić błąd |
| Żądanie kończy się nieoczekiwanie | Ograniczyć czas czyszczenia, zakończyć drzewo procesów workera i uzgodnić dzierżawę |
| GPU znika | Potwierdzić powtarzające się braki, opróżnić aktywne zadania, uruchomić jeden chroniony restart, wysłać alert i sprawdzić pełny skonfigurowany zestaw GPU |
| Miner pomija bezczynną kartę | Odbudować listę urządzeń na podstawie aktywnych dzierżaw i uruchomić minera ponownie |
| Wdrożenie LiteLLM zawodzi | Spróbować innej repliki w tej samej grupie modeli, a potem zastosować politykę awaryjną |
| Grant Aperture blokuje trasę | Naprawić tożsamość lub grant modelu, nigdy nie omijać polityki bramy |
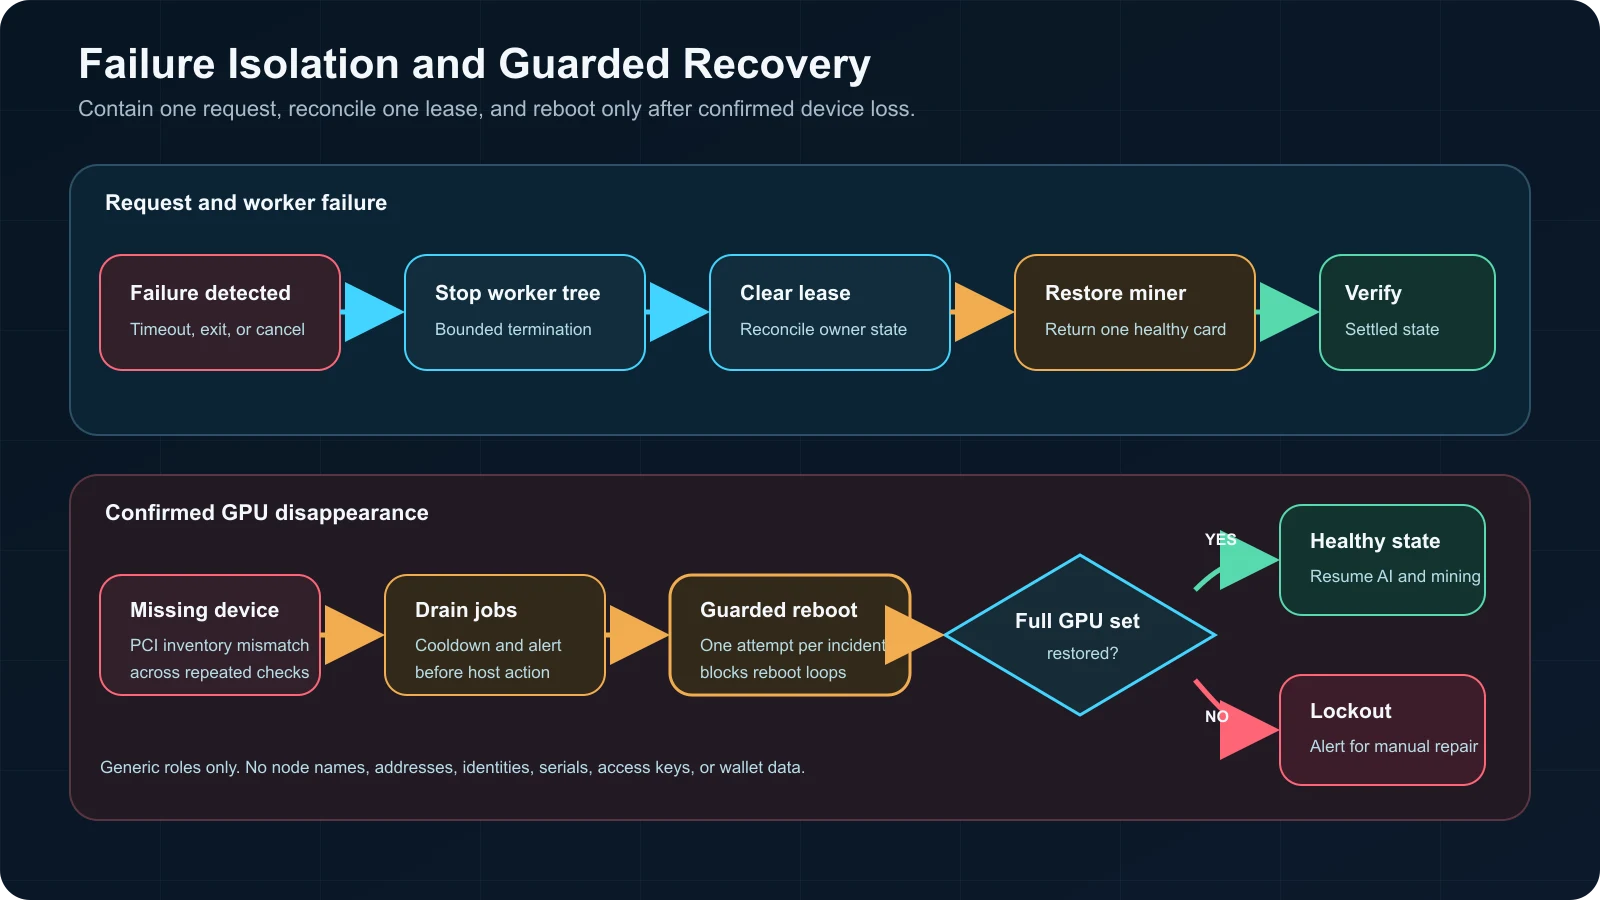
Zwykłe awarie zwalniają jedną dzierżawę, a potwierdzona utrata urządzenia uruchamia chronioną ścieżkę odzyskiwania hosta
Co się stało z eksperymentalnym brokerem
Niezależny od backendu broker ma udostępniać jeden interfejs zgodny z OpenAI dla Ollama, vLLM, llama.cpp i Strata. Obejmuje zarządzanie cyklem życia dla każdego modelu, wyładowywanie w bezczynności i przypisywanie GPU.
Testowaliśmy brokera w wersji 0.6.0, commit c12b65, 21 października 2026 roku. Lokalny zestaw testów zgłosił 1 101 testów zaliczonych i 2 pominięte, a Ruff nie wykrył błędów. Następnie canary załadowało model na żądanie i obsłużyło udane żądanie czatu. Pozostałe GPU kontynuowały mining podczas żądania.
Zamknięcie ujawniło krytyczny problem cyklu życia. Po załadowaniu modelu broker utknął w ścieżce zatrzymania, dopóki systemd nie zabił drzewa procesów. Wymuszone zatrzymanie pozostawiło przeterminowaną dzierżawę GPU aż do uzgodnienia i przywrócenia minera. Znaleźliśmy też lukę między udokumentowanym ustawieniem wymaganej GPU a egzekwowaniem go przez adapter produkcyjny.
Wyłączyliśmy brokera w ścieżce produkcyjnej. LiteLLM routuje teraz przez proxy puli działające dla każdego żądania. Broker pozostanie eksperymentalny, dopóki testy integracyjne nie potwierdzą ograniczonego zatrzymywania procesów potomnych, kończenia grup procesów, kontroli dopuszczania wymaganej GPU i czyszczenia przeterminowanych dzierżaw.
To użyteczna lekcja inżynierska. Broker niewiele udowadnia, jeśli raz uruchomi model. Gotowość produkcyjna zależy od czystego zamknięcia, ograniczonego odzyskiwania, wyłącznego dopuszczania urządzeń i powtarzalnych ćwiczeń awaryjnych.
Wykonane weryfikacje
Test wdrożenia obejmował więcej niż odpowiedź modelu:
- Każdy współdzielony model czatu wykonał cykl ładowania, odpowiedzi, zakończenia i przywrócenia Pearl na co najmniej jednym kwalifikującym się hoście.
- Wizja przyjęła obraz przez trasę czatu.
- Embeddingi zwróciły skonfigurowany rozmiar wektora przez prywatną trasę LiteLLM.
- Kilka modeli działało równocześnie na osobnych kartach.
- Niedzierżawione karty pozostały przy minerze podczas równoczesnych żądań AI.
- Współdzielone aliasy kierowały ruch między kwalifikującymi się węzłami.
- Aliasy z prefiksem węzła zachowały deterministyczne przypisanie.
- Każda brama LiteLLM wymieniała ten sam katalog logiczny.
- Brakujące GPU wróciło do działania po jednym pełnym restarcie hosta. Watchdog ma teraz trwałe zabezpieczenie przed pętlą.
- Awaria zamknięcia brokera została naprawiona przez uzgodnienie dzierżawy.
- W ustalonym stanie końcowym nie było dzierżaw AI, a każde sprawne GPU wróciło do zestawu minera.
Kontrole stanu i listy modeli nie były uznawane za testy ładowania modelu. Przydatny test akceptacyjny wysyła rzeczywiste żądanie, sprawdza odpowiedź, potwierdza wybrane GPU, obserwuje zamknięcie i weryfikuje wznowienie miningu.
Rozwiązywanie problemów floty
| Objaw | Pierwsze sprawdzenie |
|---|---|
| Model jest widoczny, ale żądania zawodzą | Identyfikator modelu upstream, format API, nagłówek uwierzytelniania i bazowy URL dostawcy |
| Aperture zwraca 405 | Bazowy URL dostawcy nie ma powielonego sufiksu /v1 |
| Żądanie trafia do złego węzła | Współdzielony alias czy alias z prefiksem węzła |
| Dwa workery używają jednej karty | Blokada dzierżawy, jej stary stan i logika dopuszczania GPU |
| Mining zatrzymuje się na wszystkich kartach | Kod restartu minera buduje listę urządzeń z aktywnych dzierżaw |
| GPU nie wraca do miningu | Drzewo procesów workera, uzgadnianie dzierżawy i lista urządzeń minera |
| Zimny start jest powolny | Rozmiar modelu, szybkość pamięci masowej, szerokość łącza PCIe i obciążenie CPU hosta |
| Długie prompty zawodzą | Skonfigurowany kontekst, zapas pamięci KV i rezerwa wyjściowa |
| W Aperture brakuje trasy embeddingów | Użyć uwierzytelnionej trasy LiteLLM ograniczonej tożsamością Tailscale i polityką zapory hosta |
| Broker zawiesza się podczas stopu | Wyłączyć trasę brokera i skierować ruch z powrotem do zweryfikowanego proxy puli |
Zasady projektowe, które warto zachować
- Kieruj według celu zadania. Sam rozmiar modelu nie określa poziomu.
- Utrzymuj politykę ponad przypisaniem. Hermes wybiera alias możliwości. LiteLLM wybiera wdrożenie. Pula wybiera GPU.
- Traktuj każde GPU jako osobną dzierżawę. Przełączanie całego hosta marnuje dostępne karty.
- Wyładowuj każdy bezczynny model. Aktywne bramy nie wymagają aktywnych workerów GPU.
- Zachowaj ograniczoną ścieżkę dokładnego przypisania. Alias węzła dostępny tylko operatorom ułatwia odtwarzalne diagnozy.
- Najpierw testuj zamykanie. Odzyskanie minera i czyszczenie dzierżawy należą do testów akceptacyjnych.
- Rozdziel czat, wizję i embeddingi. Jedna brama nie oznacza jednego protokołu.
- Usuń prywatne szczegóły z diagramów. Publikuj role i przepływy, nie adresy, klucze, tożsamości ani dane portfela.
- Zabezpiecz logikę restartów. Wymagaj powtarzających się braków, czasu wyciszenia, trwałego licznika, alertu i ręcznej interwencji po jednej nieudanej naprawie.
- Zachowaj oddzielną ścieżkę eksperymentalną. Awaria brokera nie powinna pociągnąć za sobą zweryfikowanej trasy.
Następne kroki
Kolejna faza to ocena obciążeń. Każdy poziom potrzebuje stałego zestawu zadań, kryteriów akceptacji, zapisów opóźnień, zajętości GPU, czasu przerwy w miningu i współczynników eskalacji. Pomiary pokażą, które zadania T2 należą do T3, a które zadania T3 mieszczą się w T4.
Planujemy też przeprowadzić pierwszy test akceptacyjny Hermes przez Aperture i LiteLLM, a następnie ponownie przetestować brokera po naprawie ścieżek zamykania i dopuszczania GPU. Generowanie obrazów potrzebuje własnego adaptera zgodnego z OpenAI i ładowanego na żądanie, zanim dołączy do tego samego katalogu routingu.
Aby dobrać rozmiar modelu, przeczytaj przewodnik po lokalnych modelach AI i kontekście GPU . O granicach prywatności przeczytaj w artykule Prywatność i bezpieczeństwo lokalnej AI . O konfiguracji minera i ryzyku przeczytaj przewodnik po miningu Pearl , zamiast traktować bezczynny mining jako gwarantowany zysk.

Related Posts