Modele językowe kontekstu Meta: lepsza pamięć agentów, ale nie koniec halucynacji
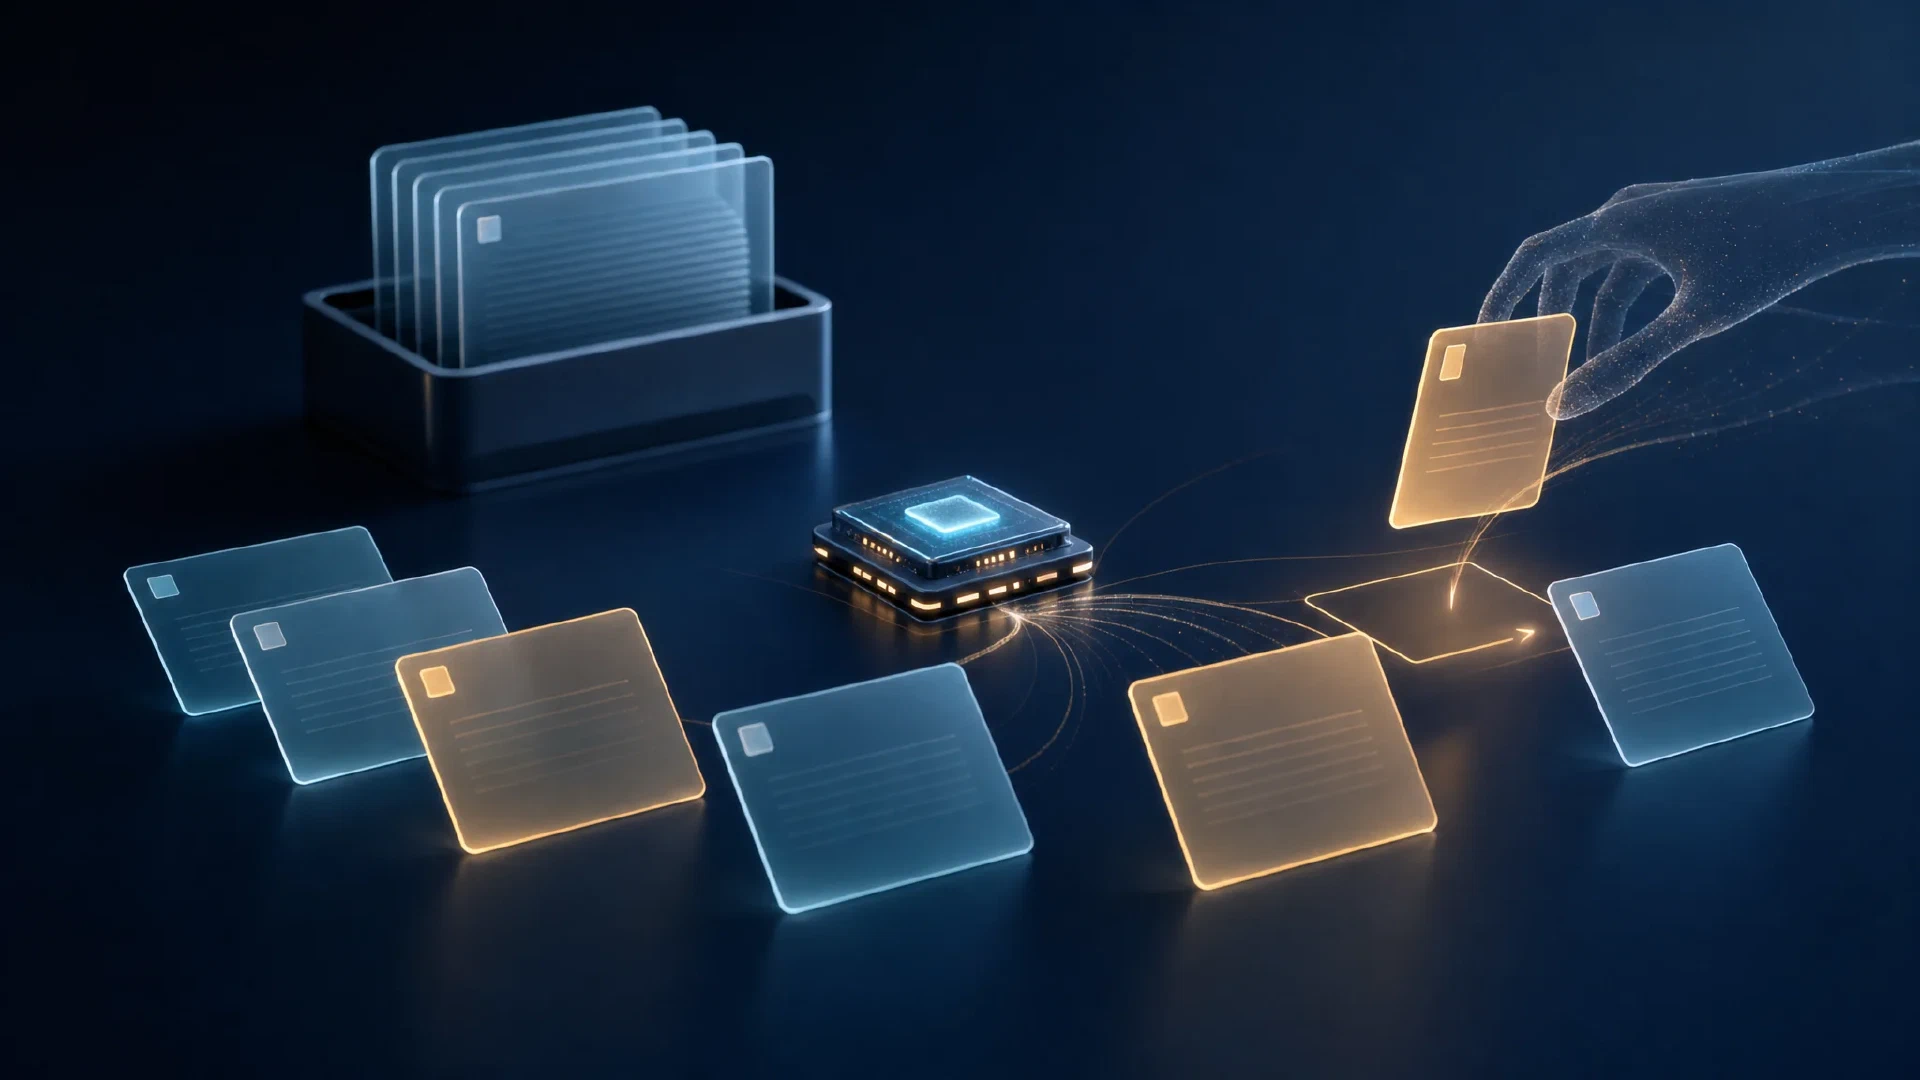
Table of Contents
Context Language Models (CLM) dają agentowi AI bezpośrednią kontrolę nad informacjami dostarczanymi do kolejnego wywołania modelu. Podejście poprawia zarządzanie kontekstem w kilku opublikowanych ewaluacjach, lecz nie dowodzi końca halucynacji. Agent nadal potrzebuje dowodów dla swoich twierdzeń i niezależnych kontroli swojej pracy.
Pytanie inżynierskie brzmi, czy selektywna edycja zachowuje właściwe fakty przy akceptowalnym koszcie. Krótsza rozmowa jest użyteczna tylko wtedy, gdy agent zachowuje wymagania, odróżnia obserwacje od założeń i w razie potrzeby pobiera dowody.
Najważniejsze wnioski
- Edytowalny kontekst: CLM opisuje metodę wykonywania dla istniejących modeli, z opcjonalnym treningiem poprawiającym jej użycie.
- Zyski warunkowe: rozmiar modelu, budżet kontekstu, zadanie i backend serwowania wpływają na wyniki.
- Rozliczanie obliczeń: FLOPs ponownego użycia prefiksu obejmują obliczenia po edycjach, lecz nie mierzą bezpośrednio czasu ani rachunku.
- Integralność pamięci: własne notatki agenta pozostają omylonymi i potencjalnie niebezpiecznymi danymi wejściowymi.
- Praktyczna ewaluacja: mierz razem zaakceptowane wyniki, utracone fakty, niepoparte twierdzenia i koszt odzyskiwania.
Oddziel pamięć od dowodów
Okno kontekstu zawiera dane wejściowe dostępne modelowi podczas wywołania. Instrukcje, odpowiedzi narzędzi, notatki robocze i wcześniejsze wiadomości konkurują o miejsce. Kompaktowanie zastępuje część tych danych krótszą reprezentacją.
Rozważ przykładowe zadanie aktualizacji zależności. Runner testów zgłasza dwa błędy. Agent kompresuje historię do notatki mówiącej, że aktualizacja się udała. Późniejsza praca zaczyna się więc od błędnego założenia, mimo że pierwotny wynik testów pozostaje na dysku.
Zmiana metody kompaktowania wpływa na sposób wejścia błędnej notatki do pamięci roboczej. Nie zastępuje runnera testów jako dowodu. Przed zaakceptowaniem aktualizacji proces nadal potrzebuje świeżego wyniku testu albo możliwego do sprawdzenia zapisu odpowiedniego uruchomienia.
| Błąd | Właściwa kontrola |
|---|---|
| Utracone wymaganie | Porównaj bieżący stan z pierwotnymi kryteriami akceptacji |
| Zmyślona obserwacja | Dopasuj twierdzenie do wyniku narzędzia albo zapisu źródłowego |
| Błędne rozumowanie | Sprawdź wniosek względem oczekiwanego zachowania zadania |
| Nieautoryzowana instrukcja | Egzekwuj uprawnienia poza notatkami zapisanymi przez model |
To rozróżnienie ma znaczenie przy ocenie każdej techniki pamięci. Zachowanie i poprawność to osobne cechy. System, który doskonale zachowuje nieprawdziwe twierdzenie, nadal pozostaje niepoprawny.
Co zmieniają CLM
Rulin Shao i współautorzy, w tym badacze z Meta Superintelligence Labs i University of Washington, przedstawili CLM w preprincie z 29 września 2026 roku. Ich implementacja udostępnia bieżący kontekst jako edytowalny plik. Agent używa poleceń powłoki lub kodu do jego modyfikacji, a środowisko dostarcza zmienioną zawartość przy kolejnym wywołaniu. Zobacz Context Language Models .
Ordinary continuation:
existing context + new response + new tool output

Editable-context continuation:
agent revises context file -> runtime loads revised context -> next model call
Architektury modelu nie trzeba zastępować w podejściu zero-shot. Środowisko dodaje możliwość do istniejącego modelu. Artykuł osobno bada instrukcje, wyuczone strategie zarządzania kontekstem i uczenie ze wzmocnieniem.
Plik notatek działa inaczej. Odczyt zapisanej notatki dodaje jej zawartość do rozmowy. Późniejsza edycja pliku nie usuwa automatycznie starego tekstu z aktywnego kontekstu. CLM wymaga obsługi środowiska, która synchronizuje zmiany z kolejnymi żądaniami. Oficjalna implementacja zawiera kod agenta i osobne rozszerzenie serwujące.
Zewnętrzne przechowywanie nadal jest przydatne. Zachowuj szczegółowe logi i dokumenty źródłowe do pobrania, a w pamięci roboczej trzymaj zwięzłe odwołania. Położenie dokumentu i wspierane przez niego twierdzenie często mają większą wartość niż zachowanie każdej linii w następnym promptcie.
Czytaj wyniki uważnie
Poprawy benchmarków są konkretnymi porównaniami. Poniższe ustalenia pochodzą z ewaluacji autorów, a nie z testów wykonanych na potrzeby tego artykułu. Badanie jest preprintem, a wybrany benchmark nie dowodzi niezawodności w dowolnym procesie.
| Ewaluacja | Zgłoszony wynik | Interpretacja |
|---|---|---|
| BrowseComp-Plus, zero-shot | 11,4% względnego wzrostu dokładności i 21,5% mniej FLOPs ponownego użycia prefiksu względem najsilniejszej bazy | W tym ustawieniu poprawiają się dokładność i obliczenia |
| TerminalBench 2.1 | Taka sama dokładność jak najsilniejsza baza przy 29,5% mniejszej liczbie FLOPs | Zysk to wydajność przy porównywalnej dokładności |
| EdgeBench, przebiegi 12-godzinne | Wynik wyższy o 5% przy 59% mniejszej liczbie FLOPs | Wynik optymalizacji oprogramowania, nie odsetek halucynacji |
| Wytrenowany Qwen3.5-9B | CLM 42,5% wobec 42,1% dla wytrenowanego podsumowania | Mała różnica dokładności przy większej różnicy obliczeń |
Porównanie wytrenowanego modelu 9B używa 1,34 wobec 2,19 PFLOP na pytanie, czyli około 38,8% mniej obliczeń dla CLM. Wzrost z 28,8% przed treningiem do 42,5% po treningu jest innym porównaniem niż różnica 0,4 punktu wobec wytrenowanego podsumowania. Zawsze podawaj bazę. Zobacz wyniki i tabelę treningu w artykule .
Procenty względne także wymagają mianownika. Wzrost z około 53,3% do 59,4% to około 6,1 punktu procentowego albo 11,4% względnie. Żadne z tych wyrażeń nie oznacza, że system odpowiada poprawnie na każde pytanie.
Budżet kontekstu zmienia wyniki
Budżet kontekstu 32K pojawia się w głównych ewaluacjach. Tworzy istotne ograniczenie zachowywania i edycji. Wyników przy takim budżecie nie należy uogólniać na każde wdrożenie z większym oknem.
Przy 128K w EdgeBench-10 załącznik F podaje poniższe wyniki dla dziesięciu zadań i trzech ziaren:
| Metoda | Wynik końcowy | Średnie PFLOP ponownego użycia prefiksu na próbę |
|---|---|---|
| Podsumowanie | 47,8 | 222 |
| CLM | 47,3 | 142 |
| CLM z podagentami | 50,2 | 219 |
Dokładność pojedynczego agenta jest zbliżona, a CLM zużywa w tym porównaniu około 36% mniej obliczeń. Konfiguracja z podagentami ponownie zmienia wynik. Pojemność kontekstu, konfiguracja agenta i budżet obliczeń należą do porównania obok nazwy metody.
Możliwości modelu nadal mają znaczenie
Mniejsze modele nie zarządzają pamięcią automatycznie dobrze. W porównaniu treningowym niewytrenowany CLM 9B zaczyna poniżej bazowego podsumowania. Osobna ewaluacja uzupełniająca podaje 39,9% wobec 37,7% w BrowseComp-Plus. To różne ustawienia eksperymentalne, a nie wymienne pomiary.
Uzupełniająca analiza TerminalBench podaje również brak edycji kontekstu w połowie zadań 9B. Udostępnienie modelowi interfejsu edycji nie gwarantuje skutecznego użycia interfejsu. Oceniaj wybrany model i ustawienia, zamiast traktować CLM jako uniwersalną aktualizację.
Uwzględnij ponowne przetwarzanie
Cache KV przechowuje pośrednie obliczenia uwagi. Przy zwykłym cache prefiksu niezmieniony tekst na początku następnego żądania ponownie wykorzystuje wcześniejsze obliczenia. Edycja blisko początku skraca ponownie używalny prefiks i wymusza ponowne przetworzenie późniejszego tekstu.
Previous request: A + B + C
Revised request:  A + replacement for B + C

Standard prefix reuse:
reuse A, recompute replacement for B and C
Metryka FLOPs ponownego użycia prefiksu w artykule liczy generowanie i przetwarzanie promptu po pierwszym niezgodnym miejscu. PFLOP oznacza 10¹⁵ operacji zmiennoprzecinkowych. To szacunkowa suma obliczeń, a nie ocena jakości, pomiar przepustowości ani faktura.
Przykład 7,7× z załącznika C używa przykładowego promptu 20 000 tokenów i odpowiedzi 500 tokenów. Edycja na początku kosztuje 7,7 raza tyle co modelowana tura dopisywania z ponownie używalnym prefiksem 18 000 tokenów. To kara za ponowne obliczenia przy określonych długościach, a nie zmierzony spadek halucynacji o 7,7 raza.
Lokalne opóźnienie zależy od przepustowości promptu. Jako przykład arytmetyczny ponowne odczytanie 24 000 tokenów przy założeniu 800 tokenów na sekundę trwa 30 sekund przed doliczeniem innych kosztów. To nie jest benchmark konkretnego Maca ani GPU. Zmierz backend, kwantyzację i rzeczywiste rozmiary promptów, których zamierzasz używać.
Dyskusja llama.cpp o ponownym przetwarzaniu modeli hybrydowych pokazuje, dlaczego znaczenie mają zmiany prefiksu i punkty kontrolne stanu rekurencyjnego. Nie dowodzi identycznego zachowania we wszystkich wydaniach ani aplikacjach używających llama.cpp. Zapisuj wersję środowiska i sprawdzaj logi cache.
Oszczędności cache mają granice
Suffix Cache Reuse (SCR) zachowuje stany cache dla tekstu, który przetrwał edycję. Wydane rozszerzenie celuje w SGLang, a README wskazuje wersję 0.5.16. To osobna optymalizacja serwowania, nie warunek podstawowej metody edytowalnego kontekstu.
Ponowne użycie jest przybliżone. Zachowane tokeny mają stany obliczone w poprzednim kontekście. Zgodność wyników benchmarku nie dowodzi więc równoważności numerycznej z pełnym ponownym obliczeniem nowego promptu.
Autorzy podają 35% mniej obliczeń po stronie serwera w porównaniu BrowseComp-Plus. Z 7,8 punktu procentowego dodatkowo ponownie użytych tokenów promptu 5,3 pochodzi z usuniętych bloków rozumowania, a 2,5 z innych edycji. Duża część korzyści wykracza więc poza jawną edycję CLM. Zobacz notatki implementacyjne SCR .
Przy rozliczaniu API rozdziel zwykłe wejście, zapisy cache i odczyty cache. Anthropic podaje dla Sonnet 4.6 odpowiednio 3, 3,75 i 0,30 USD za milion tokenów dla zwykłego wejścia, pięciominutowych zapisów cache i trafień cache. Zapisanie 20 000 tokenów jako cache kosztuje 0,075 USD, a trafienie 0,006 USD. Różnica 0,069 USD nie obejmuje wyjścia ani innych modyfikatorów rachunku. Dokumentacja cache promptów , sprawdzona 10 października 2026.
Całkowity koszt zadania rozstrzyga kompromis. Sporadyczne drogie edycje nadal dają oszczędności, jeśli znacznie ograniczają późniejsze wejście. Częste edycje, po których zostaje niewiele tur, dają mniej okazji do odzyskania kosztu.
Sprawdź zachowanie cache w używanej ścieżce serwowania. Pomiary ponownego użycia w artykule nie dowodzą, że API, wydanie SGLang ani lokalne środowisko udostępnia te same elementy sterowania cache. Podczas pilota zapisuj trafienia cache, tokeny promptu, ponowne obliczenia i zachowanie resetu. Brak telemetrii traktuj jako ograniczenie ewaluacji.
Trzymaj notatki poniżej instrukcji
Pamięć zapisana przez model to niezaufane dane zadania. Zawiera obserwacje, interpretacje i czasem błędy. Traktowanie każdej notatki jako instrukcji daje tym błędom władzę nad przyszłymi działaniami.
OpenAI opisało 27 przypominających jailbreak podsumowań kompaktowania w osobnym treningu nieopublikowanego modelu z rodziny Astra. Część wstrzykniętych instrukcji zignorowano, a ograniczenia konkretnego zadania wpłynęły na jedną zgłoszoną kontynuację. Raport opisuje rzadkie zachowanie i stwierdza, że regeneracja nie odtworzyła go w finalnym modelu Astra ani w checkpointach użytych do ruchu. To dowód trybu awarii, nie jego częstości w używanych CLM. Zobacz raport OpenAI o wstrzyknięciach do podsumowań kompaktowania .
Implementacja obronna powinna rozdzielać te obowiązki:
| Komponent | Sposób traktowania |
|---|---|
| Wymagania użytkownika i uprawnienia | Zachowaj poza warstwą edytowalnych notatek |
| Notatki robocze | Zezwól na rewizję, zachowaj pochodzenie i oznacz niepewność |
| Oryginalne dowody | Trzymaj niezależne od podsumowań i możliwe do pobrania |
| Działania i edycje | Loguj zmiany i egzekwuj kontrolę dostępu w kodzie |
Usunięcie nie musi oznaczać wymazania. SCR zachowuje stany, na które wpłynął wcześniejszy kontekst. Jako wniosek inżynierski nie traktuj usunięcia tekstu z edytowalnego pliku jako dowodu usunięcia całego wpływu ze stanu cache. Testuj jawny reset, gdy proces wymaga czystego restartu.
Testuj ograniczony pilotaż
Zacznij od wymagań retencji, a nie od reklamowanej długości kontekstu. Wybierz powtarzalne zadanie ze znanymi odpowiedziami, niezmiennymi rekordami wejściowymi i jasnym sprawdzeniem ukończenia. Do pierwszego porównania użyj piaskownicy z danymi syntetycznymi.
- Utwórz dokładne fakty: dodaj identyfikatory, zmienione wymagania, nieudane próby i jedną poprawioną wartość.
- Uruchom porównywalne konfiguracje: stałe podsumowanie, edytowalny kontekst i przepływ notatek w nowej sesji.
- Utrzymaj stałe wejścia: użyj tego samego modelu, zestawu zadań, narzędzi, limitów generowania i budżetu kontekstu.
- Sprawdź po zmianach pamięci: przetestuj dokładne odtwarzanie, pobieranie źródła oraz oznaczenie zastąpionych faktów jako nieaktualnych.
- Mierz cały przebieg: zapisuj wskaźnik sukcesu, niepoparte twierdzenia, czas, edycje, odzyskiwanie po przepełnieniu i ręczne poprawki.
Rozliczanie tokenów należy do środowiska uruchomieniowego. Załącznik G wskazuje ograniczoną świadomość długości kontekstu w testowanych modelach, a wskazówki środowiskowe poprawiają szacunki. Ustawienie eksperymentalne obejmuje także odzyskiwanie po przepełnieniu. Dostarczaj zmierzone liczby tokenów i rezerwuj miejsce na odpowiedź, zamiast polegać na szacowaniu pojemności przez model.
Awaryjna ścieżka oparta na notatkach jest przydatna, gdy edycja aktywnego kontekstu jest niedostępna. Handoff powinien być krótki i powiązany z dowodami. Poniższy zapis jest przykładowy, nie stanowi formatu API CLM:
objective: Upgrade the dependency without changing export behavior
verified:
  - claim: Date export test still fails
    evidence: artifacts/export-test-result.txt
superseded:
  - claim: All tests passed
    reason: Contradicted by the retained test result
unknown:
  - Whether the parser change affects empty input
next_step: Test empty input before changing the formatter
Nowa sesja nadal płaci za odczyt tej notatki, a zła notatka nadal przenosi złe informacje. Otwieraj dowody dla ważnych twierdzeń i zachowuj dostęp do pierwotnej specyfikacji zadania. Ten proces jest opcją zgodności, nie dowodem zysków równoważnych CLM.
Decyduj na podstawie zaakceptowanych wyników
Testuj CLM, gdy długie zadania wielokrotnie tracą użyteczny stan albo zużywają znaczne obliczenia na przestarzały kontekst. Krótka interakcja z małą historią daje mniej okazji dla tej optymalizacji.
Oficjalne repozytorium ma licencję CC BY-NC 4.0. Przed użyciem implementacji w projekcie komercyjnym sprawdź licencję . Publiczna dostępność kodu sama w sobie nie daje nieograniczonego prawa do użycia komercyjnego.
Celem jest niezawodne ukończenie. Zachowaj metodę tylko wtedy, gdy poprawia zaakceptowane wyniki albo obniża koszt bez osłabienia kontroli dowodów. W sprawie powiązanych decyzji wdrożeniowych przeczytaj porównanie lokalnej AI i ChatGPT oraz przewodnik po GPU i planowaniu kontekstu .
Źródła
- Rulin Shao i in.: Context Language Models , 29 września 2026, wraz z pełnymi wynikami i załącznikami .
- Implementacja badawcza Meta: repozytorium Context Language Models .
- Implementacja serwowania: dokumentacja Suffix Cache Reuse .
- Anthropic: Cache promptów .
- OpenAI: Samodzielnie generowane wstrzyknięcia promptów w podsumowaniach kompaktowania .
- llama.cpp: Dyskusja o ponownym przetwarzaniu promptów modeli hybrydowych .
- Kai: Koniec halucynacji AI? Nowa poprawka Meta (CLM) .
Related Posts