Certyfikaty cyberbezpieczeństwa AI: nie nadążają za praktyką

Table of Contents
Podchodziliśmy do egzaminów. Zdaliśmy je. Otrzymaliśmy certyfikaty i poczuliśmy rozczarowanie, które chcę dokładnie opisać.
Nie jest to zarzut wobec osób, które stworzyły te programy. Pracują z niekompletnymi materiałami. Bezpieczeństwo AI jako dziedzina jest młode. Badania nad atakami rozwijają się szybciej niż narzędzia obronne. Ramy zarządzania pojawiły się przed wskazówkami inżynieryjnymi.
Problemem jest różnica między tym, czego uczą certyfikaty, a tym, co trzeba wiedzieć, aby skutecznie zabezpieczać systemy AI w środowisku produkcyjnym.
Trzy często mylone warstwy
Zanim wyjaśnię, czego brakuje, warto rozdzielić to, co już istnieje.
Pierwsza warstwa to zarządzanie. Dokumenty takie jak NIST AI Risk Management Framework (AI RMF 1.0, 2023), ISO/IEC 42001:2023 i EU AI Act działają na poziomie organizacyjnym i procesowym. Opisują zarządzanie ryzykiem AI, strukturę nadzoru i dokumentowanie odpowiedzialności. Celowo skupiają się na zarządzaniu, a nie na szczegółowych kontrolach. Takie jest ich założenie.
Druga warstwa to taksonomia zagrożeń. MITRE ATLAS dokumentuje taktyki adwersarialne przeciwko systemom AI w formacie stosowanym przez ATT&CK. OWASP Top 10 for Large Language Model Applications wymienia klasy ataków najbardziej istotne dla wdrożonych LLM. Dokumenty te nazywają ataki i opisują ich działanie. Nie określają metod obrony.
Trzecia warstwa to wskazówki techniczne. Obejmuje Google Secure AI Framework (SAIF), Microsoft AI Security SDL, OWASP AI Exchange, NIST AI 600-1 (Generative AI Profile) oraz dokumentację bezpieczeństwa dostawców, takich jak Anthropic, OpenAI i Meta. Materiały te zawierają wskazówki inżynieryjne dotyczące bezpiecznego wdrażania, praktyk oceny i kontroli w czasie działania.
Większość certyfikatów zarządzania AI dokładnie omawia pierwszą warstwę. Drugą przywołuje na poziomie ogólnym. Trzeciej prawie nie porusza.
Zakres certyfikatów
Dostępne certyfikaty zarządzania i bezpieczeństwa AI, w tym IAPP AI Governance Professional (AIGP), ISACA AI Fundamentals Certificate, certyfikaty ISO 42001 i CompTIA AI+, obejmują podobny zestaw tematów.
Uczysz się NIST AI RMF i mapowania czterech funkcji: Govern, Map, Measure oraz Manage, na wdrożenie AI w swojej organizacji. Poznajesz klasyfikację poziomów ryzyka w EU AI Act i przebieg oceny zgodności dla systemów wysokiego ryzyka. Uczysz się o stronniczości, sprawiedliwości, przejrzystości i odpowiedzialności jako zasadach zarządzania. Dowiadujesz się, jak tworzyć polityki zarządzania AI i przeprowadzać oceny wpływu.
To praktyczne umiejętności. Organizacje potrzebują osób, które rozumieją ramy zarządzania, czytają NIST AI RMF i wiedzą, co dokument wymaga od nich zbudować.
Certyfikaty nie uczą z taką samą dokładnością:
- Jak napastnicy obecnie kompromitują systemy AI w środowisku produkcyjnym
- Jak operacyjnie wygląda obrona warstwowa przed prompt injection i dlaczego pojedyncza kontrola go nie eliminuje
- Jak przed wdrożeniem zweryfikować integralność modeli
- Na czym polega red teaming AI i jak określić jego zakres
- Jak przed uruchomieniem ocenić zachowanie modelu wobec wejść adwersarialnych
- Jak wygląda obserwowalność AI podczas inferencji
- Czym reagowanie na incydenty AI różni się od standardowych playbooków IR
- Jak zabezpieczać agentów AI z dostępem do narzędzi i zewnętrznych integracji
NIST AI RMF dotyczy zarządzania, a nie inżynierii
NIST AI RMF to dobrze opracowany dokument. NIST zaprojektował go jako neutralny technologicznie, niezależny od sektora i odpowiedni dla różnych metod rozwoju AI. Dzięki temu ramy mają szerokie zastosowanie.
Oznacza to również, że dokument nie zaleca technicznych kontroli dla konkretnych klas ataków. Jeśli organizacja w pełni przyjmie AI RMF i przypisze wszystkie jego funkcje do swojego wdrożenia AI, będzie mieć udokumentowane procesy zarządzania ryzykiem. Nie musi to oznaczać ochrony wdrożonego modelu językowego przed prompt injection.
NIST przyznaje to wprost. NIST AI 600-1, Generative AI Profile, opublikowany w 2024 roku, rozszerza AI RMF specjalnie o generatywną AI i duże modele językowe. Obejmuje ryzyka takie jak prompt injection, zatruwanie danych i zagrożenia informacyjne z dokładnością, której brakuje w podstawowym AI RMF. Jeśli certyfikat obejmował podstawowy AI RMF bez AI 600-1, pominięto dokument najbardziej istotny dla obecnie wdrożonych systemów.
ISO 42001 a systemy zarządzania
ISO 42001:2023 to norma systemu zarządzania AI. Zapewnia strukturę do zarządzania rozwojem i wdrażaniem AI na poziomie organizacji. Specjaliści ds. bezpieczeństwa dostrzegą podobieństwo do ISO 27001 dotyczącej bezpieczeństwa informacji.
ISO 27001 jest szeroko stosowana. Certyfikowane organizacje nadal padają ofiarą włamań. Certyfikat potwierdza, że system zarządzania istnieje, działa według określonego procesu i podlega przeglądom. Nie potwierdza, że systemy objęte tym procesem są odporne na kierowane przeciwko nim ataki.
ISO 42001 zapewnia dyscyplinę organizacyjną. Certyfikacja informuje zainteresowane strony, że procesy AI są udokumentowane, sprawdzane i podlegają zarządzaniu. Nie dowodzi, że wdrożone modele tworzą spójne odpowiedzi w warunkach adwersarialnych, agenci działają w określonych granicach zaufania ani że modele dostrojone korzystają ze zweryfikowanych danych treningowych.
To ta sama luka, którą znamy z ISO 27001. W tradycyjnym cyberbezpieczeństwie nauczyliśmy się z nią żyć. Nie powinniśmy udawać, że certyfikaty zarządzania AI ją zamykają, skoro mają takie samo ograniczenie strukturalne.
EU AI Act wymaga rezultatów, ale nie określa inżynierii
EU AI Act klasyfikuje systemy AI według poziomu ryzyka: niedopuszczalne (zakazane), wysokie (wymagana ocena zgodności), ograniczone (obowiązki przejrzystości) i minimalne (brak szczegółowych wymagań).
Systemy wysokiego ryzyka obejmują m.in. infrastrukturę krytyczną, identyfikację biometryczną, rekrutację, edukację i egzekwowanie prawa. Podlegają wymaganiom dotyczącym dokumentacji technicznej, nadzoru człowieka i odporności. Ustawa wyraźnie wymaga, by systemy AI wysokiego ryzyka były odporne na próby zmiany zachowania za pomocą manipulacji adwersarialnej.
Wymóg znajduje się w tekście ustawy. Celowo określa ona rezultaty zamiast przepisywać kontrole techniczne. Nie ma jeszcze uzgodnionych metod technicznych wykazywania odporności adwersarialnej we wszystkich kontekstach wdrożenia, typach systemów i przypadkach użycia.
Certyfikaty oparte na EU AI Act przygotowują do klasyfikowania systemów AI, tworzenia dokumentacji technicznej i opracowywania protokołów nadzoru. Przygotowują do audytu. Inżynieryjna praca potrzebna do stworzenia systemu spełniającego wymóg odporności należy do innej dziedziny niż ta, którą obecnie obejmują certyfikaty.
Jakie ataki rzeczywiście wymierzone są w systemy AI
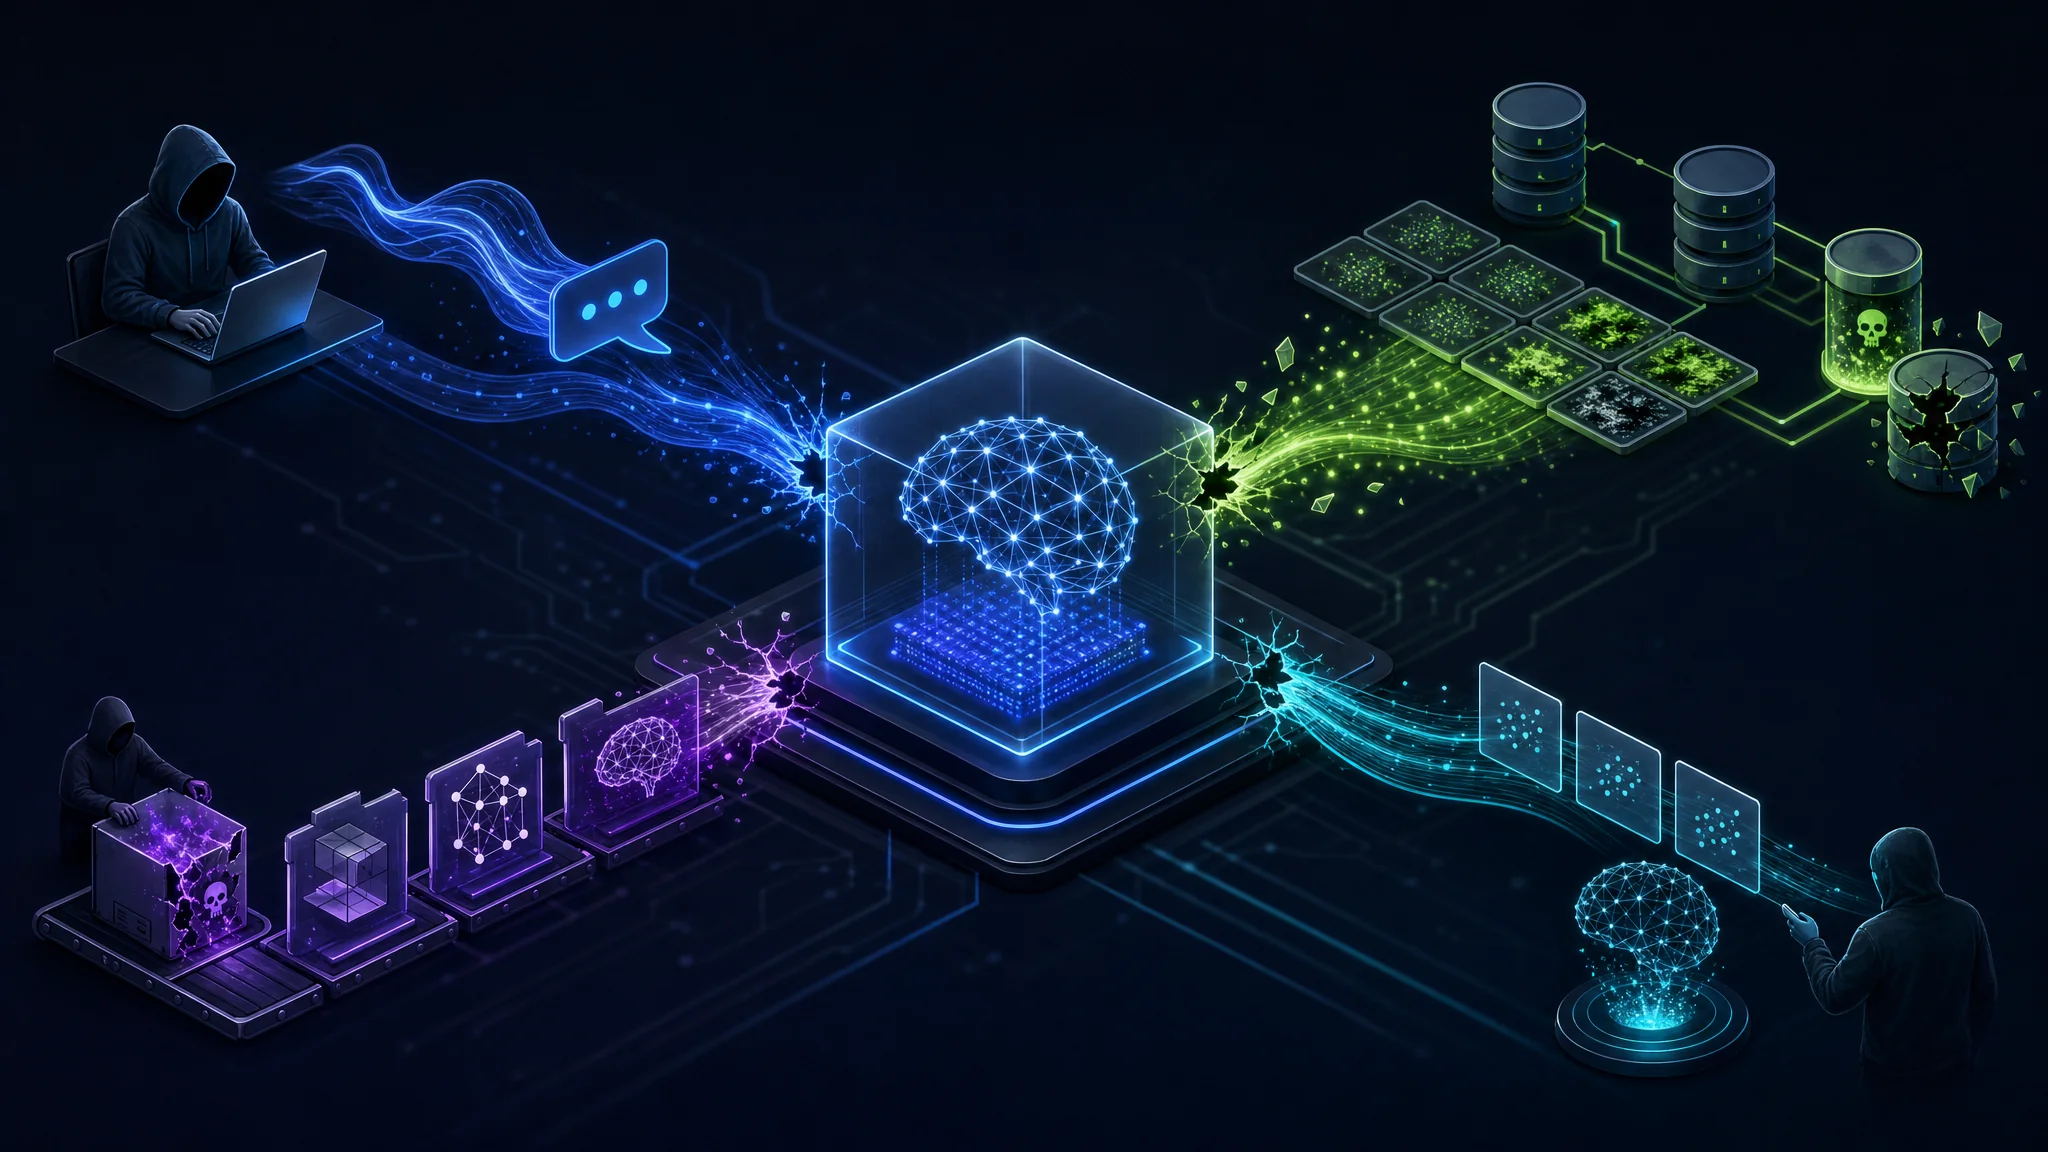
MITRE ATLAS i OWASP LLM Top 10 dokumentują operacyjny krajobraz zagrożeń. Te źródła wymieniają ataki z użytecznym poziomem szczegółowości. Ramy zarządzania opisują zagrożenia bardziej ogólnie. Poniższe informacje pochodzą z wyspecjalizowanych źródeł bezpieczeństwa.
Prompt injection polega na przekazaniu modelowi językowemu wejścia, które nadpisuje lub manipuluje instrukcjami systemowymi. Bezpośredni atak celuje w wejście modelu. Atak pośredni ukrywa złośliwe instrukcje w treści pobieranej, przetwarzanej lub streszczanej przez model. Pipeline RAG odczytuje dokument kontrolowany przez napastnika i wykonuje ukryte w nim polecenia. Agent przeglądarki odwiedza stronę napastnika i wykonuje osadzone instrukcje. Bot obsługi klienta streszcza artykuł pomocy zawierający polecenie zignorowania zasad bezpieczeństwa.
W 2026 roku nie istnieje uniwersalnie skuteczna ochrona przed prompt injection. Obrona warstwowa ogranicza ryzyko: filtrowanie wejść, walidacja wyjść, ograniczone uprawnienia narzędzi, środowiska wykonawcze w piaskownicy i ludzkie zatwierdzanie ważnych działań. Żaden z tych środków nie eliminuje całej klasy ataków. NIST, OWASP, Anthropic, OpenAI, Google i Microsoft zalecają wiele warstw kontroli zamiast pojedynczego rozwiązania.
Zatruwanie danych treningowych polega na wprowadzaniu złośliwych przykładów do zbioru treningowego, aby pogorszyć zachowanie modelu, dodać tylne wejścia lub zaszczepić zachowanie wyzwalane określonymi danymi. Oznaki skutecznego zatrucia często nie są widoczne, dopóki model nie otrzyma konkretnego wejścia wyzwalającego. Jeśli organizacja dostraja modele na treściach użytkowników, pobranych dokumentach lub zbiorach danych stron trzecich bez sprawdzenia ich pochodzenia, naraża się na to ryzyko.
Kompromitacja łańcucha dostaw modeli to zagrożenie, które wiele organizacji traktuje jako sprawę drugorzędną. Repozytoria modeli często rozpowszechniają wykonywalny kod wraz z wagami modelu. Niebezpieczne formaty serializacji, takie jak pickle, wielokrotnie powodowały ryzyka łańcucha dostaw. Pakiety pobierane razem z modelami mogą instalować podatne zależności. Wiele organizacji wydaje się znacznie słabiej kontrolować modele z publicznych repozytoriów niż zależności oprogramowania. Powierzchnia ataku jest porównywalna z npm, ale kultura bezpieczeństwa w tym obszarze jest znacznie mniej dojrzała.
Ekstrakcja modelu pozwala napastnikom odtworzyć modele o podobnym działaniu przez wielokrotne wysyłanie zapytań inferencyjnych do API. Powoduje to utratę własności intelektualnej i umożliwia analizowanie modelu offline w celu przygotowania bardziej ukierunkowanych ataków.
Inferencja członkostwa pozwala napastnikom z różnym poziomem pewności określić, czy konkretne rekordy danych znalazły się w zbiorze treningowym. Zależy to od architektury modelu i metody treningu. Tworzy ryzyko prywatności dla organizacji, które trenowały na danych osobowych.
Wejścia adwersarialne manipulują wyjściami modelu za pomocą starannie przygotowanych zakłóceń. Najwięcej badań dotyczy klasyfikacji obrazów, ale technika obejmuje też tekst, dźwięk i systemy multimodalne. Jeśli AI podejmuje decyzje o wykrywaniu oszustw, zdolności kredytowej, obrazach medycznych lub dostępie fizycznym, odporność adwersarialna jest cechą bezpieczeństwa, którą należy testować, a nie tylko opisać.
Wycieki danych przez systemy AI wymagają bezpośredniej uwagi. Pipeline RAG ujawniają dokumenty z bazy wiedzy, czasem użytkownikom bez uprawnień. Ujawnienie promptu systemowego odsłania szczegóły działania, które miały pozostać poufne. Wdrożenia AI dla wielu dzierżawców wymagają izolacji, którą inżynierowie tradycyjnego bezpieczeństwa aplikacji czasem bagatelizują. Takie zagrożenia regularnie pojawiają się w systemach produkcyjnych.
Agenci AI całkowicie zmieniają powierzchnię ataku
Większość certyfikatów bezpieczeństwa AI powstała, gdy systemy AI oznaczały głównie chatboty i klasyfikatory. W 2026 roku AI w przedsiębiorstwach coraz częściej oznacza agentów.
Agenci różnią się od chatbotów w ważnym aspekcie operacyjnym: wykonują działania. Agent z dostępem do narzędzi pocztowych, wewnętrznych baz danych, systemów plików, przeglądarki i wykonywania kodu nie jest chatbotem z dodatkowymi funkcjami. To autonomiczny proces, który na podstawie wyjść modelu językowego uzyskuje szeroki dostęp do rzeczywistych systemów.
OWASP utrzymuje osobny Agentic AI Top 10, ponieważ model zagrożeń agentów różni się od aplikacji czatu LLM na tyle, że wymaga oddzielnej dokumentacji.
W przypadku agenta prompt injection nie prowadzi do niechcianej odpowiedzi tekstowej. Wywołuje niechciane działanie. Pośrednia instrukcja w pobranym dokumencie może nakazać agentowi usunąć pliki, wyprowadzić dane albo wysłać wiadomości e-mail. Konsekwencją nie jest niewłaściwa odpowiedź, lecz nieuprawnione działanie na systemach dostępnych dla agenta.
Powierzchnia ataku agentów obejmuje:
- Limity wywoływania narzędzi: czy agent ma tylko minimalny zestaw narzędzi odpowiedni do danego zadania
- Zakres poświadczeń: czy poświadczenia agenta są ograniczone do wymagań każdego zadania
- Odwracalność działań: czy ważne operacje wymagają zatwierdzenia przez człowieka
- Filtrowanie wyjść: czy wyjścia agenta są sprawdzane przed uruchomieniem kolejnych działań
- Piaskownica: czy środowisko agenta zapobiega niezamierzonemu dostępowi do połączonych systemów
Większość certyfikatów zarządzania AI nie omawia projektu bezpieczeństwa agentów z taką szczegółowością.
Model Context Protocol tworzy nową powierzchnię ataku w przedsiębiorstwie
Model Context Protocol (MCP) stał się powszechnie stosowanym standardem łączenia agentów AI z zewnętrznymi narzędziami, źródłami danych i usługami. Serwery MCP udostępniają funkcje, które agenci wykrywają i wykorzystują. Integracja jest szybka i elastyczna, ale jej konsekwencje dla bezpieczeństwa nie zawsze otrzymują tyle samo uwagi.
Ryzyka specyficzne dla MCP obejmują:
- Złośliwe serwery MCP, które błędnie przedstawiają swoje możliwości i wykonują niezamierzone działania
- Zatruwanie narzędzi, gdy legalny serwer MCP zwraca dane kontrolowane przez napastnika i osadza instrukcje w odpowiedzi, która powinna zawierać tylko dane
- Narzędzia z nadmiernymi uprawnieniami, gdy integracje MCP mają szerszy dostęp, niż wymaga zadanie
- Pomieszanie granic zaufania, gdy agent traktuje instrukcje z dołączonych narzędzi MCP tak samo jak instrukcje użytkownika
Organizacje wdrażające agentów z integracjami MCP potrzebują ram do oceny zaufania do serwerów MCP, audytu uprawnień narzędzi oraz sprawdzania, czy odpowiedzi narzędzi są traktowane jako dane, a nie instrukcje.
Ocena to praktyka operacyjna pomijana przez certyfikaty
Red teaming AI i zestawy ewaluacyjne zastępują statyczne oceny bezpieczeństwa jako główne metody poznawania ryzyka modeli przed wdrożeniem i po nim.
Red teaming AI obejmuje:
- Ustrukturyzowane testy adwersarialne zachowania modelu wobec znanych technik ataku
- Testy jailbreaków z wykorzystaniem uznanych zbiorów promptów atakujących
- Testowanie odporności adwersarialnej, mierzące zmianę wyjść przy zmienionych wejściach
- Testy regresji zachowania między wersjami modelu
- Ocenę benchmarków bezpieczeństwa z użyciem opublikowanych zestawów ewaluacyjnych
NIST, Anthropic, OpenAI, Microsoft, Google i CISA zalecają red teaming AI przed wdrożeniem systemów wysokiego ryzyka. Staje się to standardowym oczekiwaniem, a nie opcjonalną praktyką.
Żaden z obecnych certyfikatów zarządzania AI nie przygotowuje odpowiednio specjalistów do określenia zakresu, przeprowadzenia ani interpretacji red teamingu wdrożonego modelu lub systemu agentowego. Certyfikaty opisują red teaming, ale nie uczą go wykonywać.
Obserwowalność AI to odrębna dziedzina
Tradycyjne logowanie bezpieczeństwa nie przenosi się bezpośrednio na systemy AI. Monitorowanie LLM lub agenta w produkcji wymaga zbierania innych danych i innej analizy.
Infrastruktura obserwowalności AI obejmuje:
- Telemetrię promptów i wyjść do wykrywania anomalii i naruszeń zasad
- Logi wywołań narzędzi przez agentów, z informacją o użytych narzędziach i argumentach
- Monitorowanie jakości wyszukiwania w pipeline RAG
- Wykrywanie i klasyfikowanie prób jailbreaku
- Monitorowanie spójności wyjść w celu wykrywania dryfu między wersjami modelu
- Śledzenie częstości halucynacji w aplikacjach wymagających dokładności faktów
- Wzorce opóźnień mogące wskazywać, że prompt injection powiększa kontekst
To rozwijająca się dziedzina. W 2026 roku większość organizacji wdrażających AI ma znacznie mniejszą obserwowalność komponentów AI niż tradycyjnej infrastruktury. Większość certyfikatów zarządzania nie opisuje odpowiedniej obserwowalności systemów AI.
Reagowanie na incydenty AI różni się od zwykłego IR
Gdy tradycyjny system zostaje przejęty, playbook IR obejmuje ograniczanie skutków, analizę kryminalistyczną i odzyskiwanie. Incydenty AI rodzą pytania, których standardowy playbook nie uwzględnia.
Przygotuj playbooki dla tych pytań, zanim będą potrzebne:
- Jak ustalić, czy model został zatruty podczas fine-tuningu
- Jak ocenić, czy nadużyto wyszukiwania RAG, aby zwrócić treść kontrolowaną przez napastnika
- Jak ustalić, czy agent wykonał nieuprawnione działania i jaki miały zakres
- Jak zweryfikować, czy aktualizacja modelu od zewnętrznego dostawcy zmieniła zachowanie istotne dla bezpieczeństwa
- Jak ustalić zachowanie modelu przed incydentem, aby porównać je z zachowaniem po incydencie
Wymaga to przygotowania przed incydentem, wcześniejszego skonfigurowania logów i telemetrii oraz runbooków specyficznych dla AI, które obejmują analizę zachowania modelu, a nie tylko ruch sieciowy i logi endpointów.
Problem aktualizacji certyfikatów
Jednym ze strukturalnych powodów, dla których certyfikaty nie nadążają za praktyką, jest szybszy rozwój bezpieczeństwa AI niż cykle aktualizacji materiałów.
Security+, CISSP i ISO 27001 obejmują dziedziny zmieniające się na przestrzeni lat. Główne powierzchnie ataku sieci, endpointów i aplikacji są względnie stabilne. Techniki ataków na AI zmieniają się w ciągu miesięcy. Techniki prompt injection, metody ataków adwersarialnych i powierzchnie ataku agentowego w 2026 roku różnią się od tych z czasu uruchomienia pierwszych certyfikatów AI w 2023 i 2024 roku.
Jednostki certyfikujące aktualizują materiały według harmonogramu. OWASP LLM Top 10 opublikował znaczącą rewizję w pierwszym roku. MCP nie stanowił jeszcze problemu dla przedsiębiorstw, gdy projektowano wiele obecnych certyfikatów AI. Ramy bezpieczeństwa agentowej AI powstały później niż większość obecnych programów certyfikacyjnych.
To problem strukturalny, a nie brak dobrych intencji. Czytaj źródła pierwotne na bieżąco, zamiast traktować certyfikat jako stały zasób wiedzy.
Co powinny zawierać certyfikaty bezpieczeństwa AI
Aby programy certyfikacji odzwierciedlały obecną praktykę bezpieczeństwa AI, powinny obejmować:
- Warstwową obronę przed prompt injection: filtrowanie wejść, walidację wyjść, ograniczanie narzędzi, piaskownice i zatwierdzanie działań przez człowieka, wraz z opisem ograniczeń każdego środka
- Weryfikację łańcucha dostaw modeli: ryzyka niebezpiecznej serializacji, wymagania SBOM, dokumentację pochodzenia i weryfikację podpisanych artefaktów
- Architekturę bezpieczeństwa agentów AI: granice zaufania, minimalne uprawnienia narzędzi, odwracalność działań i wymagania monitorowania
- Bezpieczeństwo MCP i integracji zewnętrznych: ocenę zaufania do serwerów narzędzi, audyt uprawnień oraz rozdzielenie danych od instrukcji
- Ocenę i red teaming: określanie zakresu oceny adwersarialnej, dostępne benchmarki i zbiory ewaluacyjne oraz interpretację wyników
- Obserwowalność AI: wymagane logi i telemetrię oraz ich użycie do wykrywania incydentów i reagowania
- Reagowanie na incydenty AI: planowanie scenariuszy, zbieranie dowodów dotyczących zachowania modeli i specyficzne dla AI kwestie odzyskiwania
- Zapobieganie wyciekom danych: izolację RAG, poufność promptów, kontrolę dostępu wielu dzierżawców i filtrowanie wyjść
Co zrobić teraz
Jeśli odpowiadasz za systemy AI w swojej organizacji:
Przeczytaj OWASP Top 10 for Large Language Model Applications i OWASP Agentic AI Top 10. Są bezpłatne i bardziej szczegółowe operacyjnie niż obecne płatne programy certyfikacyjne.
Przed kolejną sesją modelowania zagrożeń dla komponentu AI zapoznaj się z MITRE ATLAS. Ustal, które taktyki przeciwnika dotyczą twojej architektury, zanim zatwierdzisz projekt wdrożenia.
Przeczytaj NIST AI 600-1. Rozszerza podstawowy AI RMF o generatywną AI i jest znacznie bardziej istotny dla wdrożeń LLM i agentów niż sam podstawowy framework.
Przejrzyj Google SAIF, Microsoft AI SDL i OWASP AI Exchange, aby znaleźć wskazówki inżynieryjne, których nie dają ramy zarządzania.
Zweryfikuj pochodzenie każdego modelu wdrażanego przez organizację. Sprawdź karty modeli. Przed załadowaniem wag przeskanuj formaty serializacji pod kątem znanych klas exploitów.
Przypisz każdego agenta AI w swoim środowisku do posiadanych przez niego uprawnień. Agent z dostępem do odczytu i zapisu w wewnętrznej bazie wiedzy, poczcie e-mail i systemie plików zwiększa skutki prompt injection. Ogranicz jego poświadczenia do wymagań każdego zadania.
Wymagaj red teamingu specyficznego dla AI przed wdrożeniem modelu lub agenta w kontekście o poważnych konsekwencjach. Traktuj go jako obowiązkowy.
Zbuduj runbooki reagowania na incydenty AI teraz, zanim będą potrzebne.
Traktuj certyfikat zarządzania AI jako dokumentację warstwy procesowej. Nie jest on dokumentacją twojego poziomu bezpieczeństwa.
Źródła
- NIST AI Risk Management Framework (AI RMF 1.0), 2023
- NIST AI 600-1: Generative AI Profile, 2024
- NIST SP 1270: Towards a Standard for Identifying and Managing Bias in Artificial Intelligence
- ISO/IEC 42001:2023 Artificial Intelligence Management Systems
- EU AI Act, Regulation (EU) 2024/1689
- OWASP Top 10 for Large Language Model Applications, 2025
- OWASP Agentic AI Top 10
- OWASP AI Exchange
- MITRE ATLAS: Adversarial Threat Landscape for AI Systems
- Google Secure AI Framework (SAIF)
- Microsoft AI Security SDL documentation
- CISA Guidance on AI Cybersecurity, 2024
- Barreno et al., Can Machine Learning Be Secure?, 2006
- Biggio et al., Poisoning Attacks Against Support Vector Machines, 2012
- Goodfellow et al., Explaining and Harnessing Adversarial Examples, ICLR 2015
- IAPP AI Governance Professional (AIGP) program documentation
- ISACA AI Fundamentals Certificate program documentation

Related Posts